后训练换来效率、协作答对却留下坏状态、结论要能逐条回放:9 月 28 日–10 月 4 日三篇大模型论文
导读 9 月 28 日–10 月 4 日新挂出的三篇论文:后训练为什么拿解的覆盖面换采样效率、多智能体答对了当前问题为什么仍会留下不可信的共享状态,以及怎样让每条结论都能被逐条回放核对。

本期覆盖 2026 年 9 月 28 日至 10 月 4 日 首次在 arXiv 公开的大模型相关论文。生产时 arXiv 的索引收录到 10 月 2 日(周五)提交的条目,本轮可比对的是窗口内的周一到周五:cs.CL 756 条、cs.AI 1,771 条、cs.LG 1,828 条,按 arXiv ID 去重后 3,308 条,其中 3,143 条是 v1 新提交。三篇分别落在后训练的真实代价、多智能体协作留下的状态、工具智能体的可审计执行三个方向。挑选标准仍是问题说得清、实验能复述、结论能换成工程师和产品团队可以执行的判断。
本期三篇
| 论文 | 方法类型 | 一句话结论 | 提交日期 |
|---|---|---|---|
| Sharpening Tax in Post-Training | 后训练效果的测量与诊断 | 后训练把题目推向「总会解」和「从不解」两端,在 42 个模型与基准组合里有 36 个在 128 次采样预算下损失了覆盖面。1 | 10 月 1 日 |
| Right Answers, Wrong States: Hidden Information Failures in Multi-Agent Collaboration | 多智能体可靠性基准 | 21 个模型与设定组合平均下来,当前任务解决率 64.7%,证据核验只有 14.3%,共享状态重建只有 43.1%。2 | 10 月 1 日 |
| Actions with Receipts: Jointly Binding Claims, Evidence, and Execution for Replayable Tool-Agent Auditing | 智能体审计协议 | 把结论、来源跨度、有序执行前缀和来源版本绑成一条可回放的回执后,1,280 次跨对象移植攻击被检出 1,275 次。3 | 9 月 29 日 |
1. 后训练买到的是效率,付出的是覆盖面
元信息
Sharpening Tax in Post-Training
作者:Changdae Oh、Qi Zeng、Qi Qi、Andrey Zhmoginov、Deren Lei、Yun He、Hoang Phan、Hangoo Kang、Azalia Mirhoseini、Sharon Li(Meta Superintelligence Labs、威斯康星大学麦迪逊分校、纽约大学、斯坦福大学)
论文:arXiv:2610.01509v1 · 2026 年 10 月 1 日提交 · cs.AI(交叉 cs.LG)。1
要解决什么问题
围绕强化学习后训练,这几年一直有两种说法:一种认为它让模型学会了预训练阶段没学会的能力;另一种认为它只是把基座模型已有的少数行为放大,也就是让输出分布收窄。判断这件事的既有证据几乎都来自数学和代码题,而这两类题目有两个麻烦:预训练语料里本来就多,评测又往往只看最终答案,一条推理过程错的轨迹只要蒙对结果,也会被记成成功。4
作者把这个问题搬到智能体任务上。智能体任务要求模型多轮调用工具、读环境返回、在不确定下继续动作,这套行为在预训练语料里很少见,本来最像「后训练才学得会」的部分。于是问题变成:不给模型做后训练,它能不能当智能体用?如果给它足够的重复采样机会,它能不能解出更多种类的任务?4
方法是什么
作者用开源模型里成对的检查点做对比,一边是预训练基座,一边是它的后训练版本,共 14 个主干,来自 Gemma-4、Ministral-3、Qwen2.5、Qwen3.5 四个家族,参数量从 3B 到 35B。评测用三个需要多轮工具调用的智能体基准:BFCL v4 多轮 base split、WebShop 和 ACEBench,这三个环境会检查中间动作和状态转移,蒙对答案刷不高分数。4
作者给基座模型配了一个轻量「外架」(harness):一段与数据集无关、与模型无关的脚手架,由简单系统提示加上宽松的工具调用与解析接口组成。基座模型配外架评测,后训练模型用数据集默认的脚手架,这是在两边各自的最优配置下比较。4
「收窄税」(Sharpening Tax)是这篇论文提出的诊断指标。它的算法是:先把
pass@k 曲线上因增加采样预算而挽回的那块面积算出来,再用基座模型的单次失败率做归一化,最后拿基座的值减去后训练的值。税为正,说明后训练版本在同样的采样预算下少拿到了本该到手的成功。4针对这个税,作者给出一个采样端的改法:后验温度化分组采样(PTGS,Posterior-Tempered Group Sampling)。训练时用 Beta-Binomial 后验在线估计每个 prompt 的成功率,把成功率低的当作难题,采样温度调高;成功率高的当作熟题,温度调低。它不改动强化学习的更新公式,也不额外增加算力。4
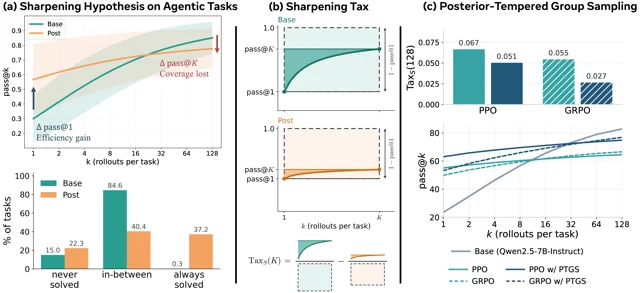
pass@k 曲线:橙线起点更高,绿线爬得更陡,在 16 次与 32 次采样之间交叉;左栏下半是同一批任务的成功率分布,绿色基座集中在「跑几次能解出」,橙色后训练版本被推向两端。中栏画出收窄税的定义:两块阴影面积相减。右栏显示加上 PTGS 后,PPO 和 GRPO 的税都下降。正文按顺序讲三段,这张图把三段并排放,读者能一眼看出交叉发生在哪一段预算上。4结果说明了什么
先看基座模型的表现。配上轻量外架之后,基座模型在智能体任务上的
pass@1 大幅提升:八个基座模型平均,BFCL 从 5.59 升到 15.63,WebShop 从 6.32 升到 9.73;对应 pass@32 从 15.19 升到 49.13、从 39.48 升到 49.15。ACEBench 上外架不起作用,两项指标分别为 44.24 到 42.63、89.25 到 87.69。同一套外架用在后训练模型上反而拖低它的成绩,说明基座和后训练模型需要的是不同的提示强度。4随着采样预算变大,基座模型的曲线会追上并反超。WebShop 上,gemma-4-31B 的基座版本在 128 次采样下能超过 85% 的
pass@128,它的后训练版本停在 56%。反超发生的预算随模型规模前移:WebShop 上,4B 的基座要到 128 次以上才反超,31B 只需要大约 3 次。4机制落在每个任务的成败分布上。用 gemma-4-31B 在 WebShop 上跑 128 次采样,把任务分成三类:中间区(一部分采样能解出)、总会解、从不解。后训练把这个分布推向两端:
| 任务类别(gemma-4-31B / WebShop,128 次采样) | 基座模型 | 后训练模型 |
|---|---|---|
| 中间区(跑几次能解出) | 87.6% | 30.0% |
| 总会解 | 0.0% | 26.0% |
| 从不解 | 12.4% | 44.0% 4 |
中间区正是「再跑几次就能多解出一题」的那部分,后训练把这里的量搬到两端,采样预算继续加大也换不回多少新成功。税在模型与基准之间不是孤例:42 个组合里,36 个在 128 次预算下
Tax_S(128) 为正。小模型在小预算下税为负,例如 Ministral-3-3B 在 8 次以内,说明算力极紧时收窄是划算的。作者还测了税的可预测性:用一半任务、8 次采样估出的税,能预测另一半任务在 32 次采样下的税,Spearman 相关系数 ρ=0.85。4PTGS 用 Qwen2.5-7B-Instruct 在 Sokoban 和 FrozenLake 两个环境上做任务级微调,各跑五个随机种子,与 PPO、GRPO 的固定温度基线对照:
| 环境与方法 | pass@1 | pass@128 | 收窄税 Tax_S(128) |
|---|---|---|---|
| Sokoban / 基座 | 20.7 | 76.6 | — |
| Sokoban / PPO | 46.5 | 55.0 | 0.094 |
| Sokoban / PPO + PTGS | 61.1 | 69.7 | 0.081 |
| Sokoban / GRPO | 36.5 | 55.3 | 0.081 |
| Sokoban / GRPO + PTGS | 39.1 | 72.5 | 0.025 |
| FrozenLake / 基座 | 26.3 | 89.1 | — |
| FrozenLake / PPO | 63.7 | 74.1 | 0.039 |
| FrozenLake / PPO + PTGS | 65.0 | 80.0 | 0.020 |
| FrozenLake / GRPO | 63.4 | 77.8 | 0.029 |
| FrozenLake / GRPO + PTGS | 67.3 | 81.2 | 0.028 4 |
四个环境与算法组合里,PTGS 同时提高了准确率和覆盖面,税都变小。作者给的解释落在训练信号上:对难题加热后,一组采样里至少出现一次成功的概率变高,同时「有成功也有失败」的混合组也变多,而后者正是 GRPO 这类分组比较算法算出非零优势所需要的。训练曲线的旁证是:固定温度的 PPO 输出熵一路下降,PTGS 的熵保持较高并多次回升,两者的验证成功率最终相同。4
读完可以带走什么
报告模型能力时,把采样效率和解的覆盖面分开报。同一份权重在不同采样预算下的表现可以差出几十个百分点,只看
pass@1 会把后训练版本的覆盖面损失藏起来;估这个损失很便宜,半个任务集跑 8 次采样就够给出一个可用的信号。选型判断跟规模绑定:模型越大、试错预算越充足,后训练带来的覆盖面损失越贵,因为大模型本来就存了更多稀少但有价值的解法。如果任务是「要一个可行的答案」,后训练版本更省算力;如果任务是「尽量多解出种类不同的题」,基座加外挂脚手架在预算够时能覆盖更多。训练侧还有一个便宜的改法:按每个 prompt 的难度调采样温度,难题多探索、熟题少浪费,可以让准确率和覆盖面一起涨。4局限一句
实验是观察性的:所用开源模型没有公开预训练与后训练的数据配方,作者也没有做控制变量的干预实验,因此作者把收窄作用表述为一条与数据一致的假设,强度停在相关性上;实验只覆盖文本型 LLM 智能体,税依赖二元成败信号,开放式生成没被纳入。4
2. 答对了当前的问题,留下的状态却是坏的
元信息
Right Answers, Wrong States: Hidden Information Failures in Multi-Agent Collaboration
作者:Herun Wan、Jiaying Wu、Minnan Luo、Zihan Ma、Fanxiao Li、Nancy F. Chen、Min-Yen Kan(西安交通大学、新加坡国立大学、云南大学、新加坡科技研究局 A*STAR)
论文:arXiv:2610.01244v1 · 2026 年 10 月 1 日提交 · cs.CL。2
要解决什么问题
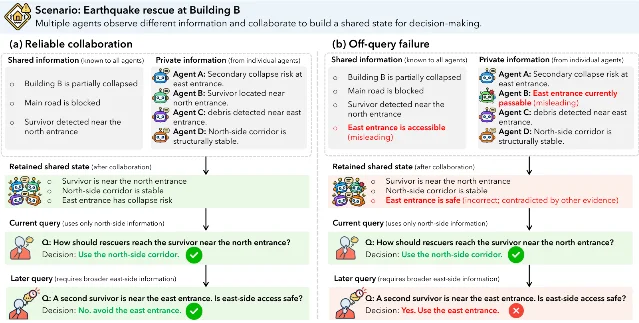
多智能体系统通常按「当前问题答对没有」来评。这个口径漏掉一种失败:协作结束时,被保留下来的那份共同信息可能是错的,只是当前这个问题恰好没碰到它。作者把这种情况叫「离题失效」(off-query failure)。5
「共享状态」在这里指的是协作过程沉淀下来、供后续推理继续引用的那份共同信息。多智能体的做法是把信息拆给不同角色,各自只看得到一部分,再靠交流拼起来;拼接时如果把一条错误信息当成了可信输入,错误就会留在状态里,等到某个后续问题真的用到它时才发作。5
方法是什么
作者提出基准 OffQuery,把通常被压成一个总分的三件事拆开评:T1 证据核验,判断哪个信息来源可信;T2 共享状态重建,在原子事实级别比对重建出的状态与可靠参考状态,看有支撑的事实是否保留、误导性的事实是否剔除;T3 当前任务解决,也就是最常用的那个答案正确率。5
数据来自两个高风险域:医疗(基于 MediQ,分 S、I 两个子集)与灾害响应(基于 CrisisFacts)。每道题先有一个可靠的全局状态,作者把它拆成「所有智能体共享」加「各智能体私有」两部分,再注入一条能支持某个错误答案、但与可靠状态冲突的证据,主设定里恰好一个智能体的信息不可信。5
注入是否有效,作者做了校验:把误导证据直接给 GPT-4o,准确率掉到 12.6% 和 6.0%(私有注入)以及 20.2% 和 5.3%(共享注入)。T2 的自动评分用三个异构裁判,聚合分的 Spearman 相关系数为 1.00,与人评的一致率 0.86、Cohen's κ 为 0.84。5
作者随后给出 ReGround:先在不看共享上下文的前提下解决智能体之间的冲突证据,再把共享上下文拆成原子事实逐条核验,保留有支撑的、剔除被反驳或没有支撑的,重建出一份可信状态,最后只在这份状态上回答当前问题。5
结果说明了什么
把 21 个「模型 × 设定」组合平均,标准多智能体协作的 T3 是 64.7%,T1 只有 14.3%,T2 是 43.1%。当前任务的表现远好于状态的可靠性。个别组合里差距更明显:GPT-5 在医疗 S 子集上 T3 到 86.2%,同一组实验里 T1 只有 10.9%、T2 只有 33.2%。模型换大主要改善的是 T3,证据核验和状态重建并没有跟着补上。5
作者把差距的来源定位到选择性使用。作者统计了决策解释里出现了哪些信息:在两个医疗子集上,不可靠信息出现在错误决策的解释里占 60.9% 和 71.7%,出现在正确决策的解释里只占 13.9% 和 19.2%;可靠信息的倾向正好相反。也就是说,答对往往是因为当前这个问题绕开了被污染的那部分状态;污染本身在协作过程中并没有被处理。5
作者换一个更宽的问题来验证这个假设:取 100 个「T3 答对、但重建状态里仍留有误导信息」的医疗实例,把原来的选择题换成覆盖诊断、鉴别、即时处置和后续步骤的宽泛临床评估。100 个实例生成的方案里,有 43% 与用可靠参考状态生成的方案不一致。同一份状态,对窄问题够用,对宽问题就不够用了。5
ReGround 在全部 21 个组合、全部三个设定上都提高了三项指标,平均相对增益分别是 T1 提升 309.0%、T2 提升 82.9%、T3 提升 17.6%。收益最大的落在标准协作最弱的证据核验和状态重建上,任务解决率也同步上升。顺序上有一条清晰的对照:先让智能体在各自的私有证据上讨论、之后再引入共享上下文,比一开始就把共享上下文摊开更好;当共享上下文本身是脏的,提前暴露会稳定地拖低表现。5
更复杂的污染下这个方法仍然有效:多个智能体都含误导信息时,表现从 45.2% 提到 60.8%;误导信息分散在多个智能体上时,从 26.4% 提到 49.7%。5
读完可以带走什么
评测多智能体系统时,除了最终答案,再单独测一次「协作结束后留下来的那份状态」:把状态拆成原子事实,逐条判断有没有证据支撑。这两件事会给出方向相反的评价,只测前者会给出过于乐观的结论。系统设计上有一条可以直接照做的顺序:先把智能体之间的冲突证据解决掉,再把可能被污染的共享上下文交给它们;提前摊开共享上下文,在它是脏的时候会稳定地拖低表现。共享状态最好有显式的维护动作:在协作结束时做一次原子事实级的核验与重建,把有证据支撑的那部分固定下来。5
局限一句
误导信息由 LLM 生成、评测也部分依赖 LLM 裁判,两个域都是模拟的高风险场景;作者在伦理声明里划定了用途:这套基准与系统面向模型可靠性研究,两个域都是模拟场景。5
3. 让每条结论都能被逐条回放核对
元信息
Actions with Receipts: Jointly Binding Claims, Evidence, and Execution for Replayable Tool-Agent Auditing
作者:Miaobo Hu、Shuhao Hu、Xiaobo Guo、Xin Wang、Bokun Wang、Yina Sa、Daren Zha、Jun Xiao(中国科学院大学人工智能学院、中国科学院信息工程研究所)
论文:arXiv:2610.00327v1 · 2026 年 9 月 29 日提交 · cs.CR(交叉 cs.AI、cs.CL、cs.LG)。3
要解决什么问题
工具智能体一般会同时给出引用和执行日志,但这两样东西各自合法,彼此之间的关联却没人审:给用户看的那句结论,是否真的由这次提交的执行产出,又是否真的由它所引用的那一段来源支撑。一条合法引用可以配上一条合法轨迹,却分别来自另外一次运行、另一个版本,甚至另一句结论。审计要能查出这类移植。6
方法是什么
作者把这件事做成一份可执行契约,叫「结论锚定的执行契约」。它的审计单元是一个四元组:被产出的结论、它在来源里的精确文本跨度、产出它的有序执行前缀、以及这次执行当时看到的来源版本与访问状态。四条信息绑在一起,才构成一次可核对的产出。6
每条「回执」(receipt)里放三部分:产出锚点,由事件下标、字段名、半开区间偏移和结论文本的 SHA-256 组成;有序的证据引用集合;以及一个域分隔的执行承诺摘要。校验时,验证器从被提交的对象里把这几项重新算出来,任何一项对不上就拒绝。6
契约把「完整性」和「语义支撑」分成两层:执行摘要的一致性由确定性校验负责,「这段来源是否真的支持这句话」交给另外一层可替换的评测器。结构上过得去,语义上仍可能站不住。6
作者列出七条可以被单独测试的性质:结论与产出绑定、来源绑定、有序执行绑定、与判别标签隔离、持久对象可回放、执行重跑一致、来源版本与访问状态绑定。判别标签的隔离指的是:模型在线运行时看不到标准答案,标签只在轨迹持久化、回放与重跑都完成之后才接入。6
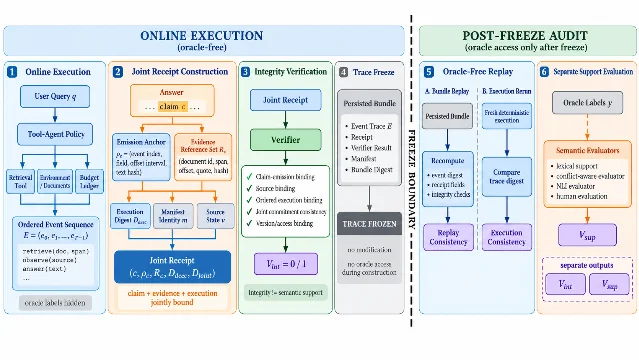
V_int 与语义支撑结果 V_sup 为什么是两路输出画清楚了。6结果说明了什么
检出能力:1,280 次跨对象移植攻击中,联合契约检出 1,275 次,检出率 0.9961,误拒率 0.0031。分类型看,来源移植与来源版本移植的检出率是 1.0000,跨运行交换是 0.9922。对照组的差距很大:只把引用和一条独立轨迹放在一起,结论移植的检出率只有 0.1797;再加一个共享的运行 ID 到 0.2266;用显式的结论锚点加联合承诺才到 0.9922。6
每条性质都是必要的。移除七条中的任意一条,针对它的那类攻击检出率掉到 0.0156 至 0.0625,其他检查不受影响。6
一条单独做的变异审计把两层的边界摆了出来。研究者从 16 份合法回执出发,各加 10 种变异。九类结构性变异——哈希、偏移、引文、文档版本、跨度、事件重排、检索失败、缺证据、判别字段注入——144 次全部被拒;而一条词面高度相似、语义却相反的对抗性结论,16 次全部被词面规则接受。也就是说,结构完整性查得出「被搬过」,查不出「说得对不对」。6
语义支撑那一层用 384 对经过独立裁决的样本评测:带冲突感知的守卫精确率 0.9213、F1 为 0.8865,误接受率 0.0729;单用词面重叠的精确率 0.7328、F1 为 0.8019,误接受率 0.3229。这批评测的标注者一致度 Cohen's κ 为 0.834。在带模型实测的三种子对照里,三种回执变体都保持了任务成功与联合回放有效性:任务成功 0.7278、语义 F1 0.8721、误接受 0.0617、联合回放有效 0.9976,平均 5.46 次调用、每个任务 16.31 秒。6
动态来源与注入压力下的数字:过期来源拒绝 0.9947、未授权跨度拒绝 0.9896、注入抵抗 0.9078、冲突解决 0.8892、受扰动任务成功 0.8127。6
代价方面,仪表化本身几乎不干扰原任务:事件轨迹完整保留率 0.9986、最终答案保留率 0.9992,任务成功差值为 0.0000。单次执行的序列化 0.19 毫秒、在线完整性校验 0.47 毫秒、bundle 回放 1.31 毫秒;单独的执行重跑需要 16.88 秒。在同一份只做一次检索的对照夹具上,多发一条回执只增加 3 个声明 token 和一次校验调用。6
读完可以带走什么
把「结论—来源—执行」的关联做成一个可以持久化、可以回放的对象,审计才有落点;系统只保存引用和日志的话,跨对象的移植几乎查不出来:这篇论文里的对照只有 0.18 到 0.23 的检出率,而显式绑定能到 0.99。系统设计时把两层分开:结构完整性由确定性校验负责,语义支撑另设一层,因为两者会给出不同答案,把结构合法当成语义成立的代理会漏掉真正危险的情况。在线执行期把判别标签拦在外面,等轨迹冻结后再接入,这样回放与重跑检验的才是轨迹本身。回执的开销按毫秒计、token 增量按个位计,落在可以常开的范围里。6
局限一句
威胁模型假定运行时与观测日志在在线执行阶段可信,这是一条明确划出的「可信记录者」边界;语义支撑仍是单独的、非确定性的评测;主夹具是固定语料加标题代理,测的是契约的执行,语义泛化由留出集另行评测。6
三篇各记一句
- 收窄税:后训练换来的是采样效率和一致性,付出的是解的覆盖面;这个代价可以用半个任务集、8 次采样估出来,也可以靠按难度调采样温度收回一部分。
- 离题失效:多智能体答对当前问题,可能只是因为这个问题绕开了被污染的那部分状态;先解决冲突证据、再交出现共享上下文,是一条可以直接照做的顺序。
- 执行回执:把结论、来源跨度、有序执行前缀和来源版本绑成一条可回放的回执,跨对象移植的检出率从 0.18 提到 0.99;它能证明「这条结论是被这次执行产出的」,语义上说得对不对仍要另一层来判。
References
- 1Sharpening Tax in Post-Training
arxiv.org
- 2
- 3
- 4Sharpening Tax in Post-Training
arxiv.org
- 5
- 6
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.