「内存又涨上去了」和「OOM Killed」,中间隔着三条曲线
内存告警只有三种形状:会回落的、只涨不落的、撞上上限的。这篇讲清容器的内存上限是谁画的、撞线之后内核怎么挑人下手,以及扩容到底买到了什么。

上一篇的结尾是:重启弄丢的那块叫内存。这一篇就从那块内存讲起——它装着什么,为什么会一直涨,涨满了会怎样。
早上九点半,群里两句话。
「服务的内存又涨上去了,要扩容吗?」
「不用吧,我重启一下。」
十点二十,同一群人:「OOM Killed,它自己重启的,我没动。」
这句话让人心里发毛。没人按按钮,服务自己没了。工程师还说,那台机器的内存空着。
先看两个问题
拿到一张内存曲线,只问两句。
一,涨上去之后,掉下来过没有。
二,按最近这一小时的速度,离那条横线还有多久。
第一句分出两件事:正常的用量,和有东西在攒。第二句决定你手上是几个小时,还是几周。
两句问完,答案落在三种处置里:别动、排期查、先顶住再查。
群里最容易达成一致的一句话是「扩容吧」。扩容买的是时间,它治不了这个病。
每处理一单就漏掉一点内存的服务,上限翻一倍,撞线时间就往后推一倍。问题还在原地,只是晚两天见你。
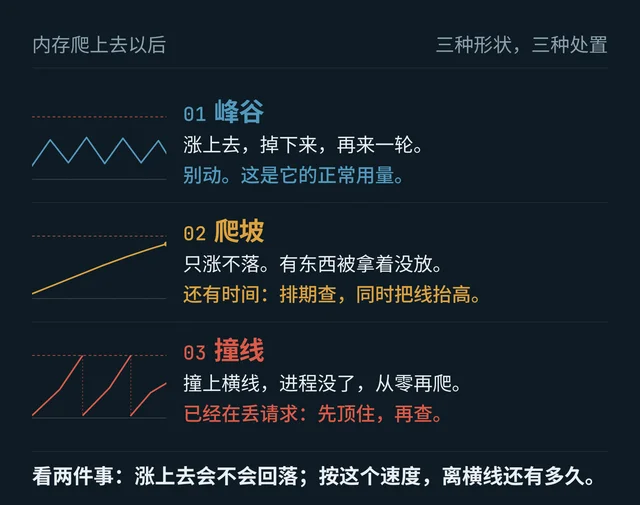
示意图由本文绘制。那条虚线是给这个容器划定的上限,它跟这台机器还剩多少内存无关;第三种形状里每撞一次线,进程就死一次、从零再爬一遍,用户的请求就落在那段空白里。
01 铺纸
磁盘上那个文件叫程序。内核把它读进内存、给它一个编号、让它开始跑,跑起来的这个东西才叫进程。关掉它,程序文件还留在原处。
一个进程手里握着几样东西:一块只有它能读写的内存、一批打开的文件和网络连接、一份用掉多少 CPU 的账。那块内存是它的私产,别的进程读不到也改不了;两个进程要交换数据,只能绕道网络或者管道。1
所以「一个进程崩了」不是「一台机器崩了」。崩的只是它自己,机器上别的进程照旧在跑。
你嘴里的「这套服务」,在工程师那里常常是好几个进程:一个收请求,一个跑后台任务,另外几个是它的副本。他数的是进程,你数的是服务,两个词经常在这儿对不上。
那条内存曲线,画的就是其中某一个。
再往里,是它内部的事。
一个进程的内存分成几块,各管各的事。
有一块放着程序本身,大小基本不动。
有一块叫栈,每次调用函数时放临时变量,函数回来就弹掉,很小,很快。
会一直变大的那块叫堆:程序运行中申请的数据都堆在这儿。用户填的表单、查出来的订单、拼好的页面,都先落在这里。1
所以看到内存涨,涨的几乎总是堆。
工程师报给你的那个数字,多半是常驻内存(RSS),指的是这个进程真正占着的物理内存。2
另有一个更大的数字叫虚拟内存,那是它「可能用到」的空间,往往远大于实际占用。
你听到「它占了 4G」,问一句是哪一个。
你会听到:「这个进程吃了 3 个 G。」「这套服务占了 6 个 G。」
问什么:你说的这个数,是 RSS 还是虚拟内存?
02 长高
堆里的东西用完了,得有东西来清。
很多语言自带一个清洁工,叫垃圾回收:它定期扫一遍堆,把再没人用的对象收走。
收不走的,是那些还被一串引用牵着的对象。清洁工顺着这串引用找得到它们,就认为还在用,于是不收。
被牵着不放,原因有两种。
第一种是有意的。这块数据下次还要用,删了就得重新查一遍数据库,于是留着。缓存就是这么长出来的。
另一种是无意的:程序忘了放手。对象还在,只是谁也再用不到它。这就是内存泄漏。3
在曲线上,这两种长得一模一样:只涨不落。
区别只有一个:留着的人知不知道自己在留。有人知道,那叫设计;没人知道,那叫泄漏。
操作系统自己也占内存。读过的文件它留在内存里,下次不必再读盘,这部分叫文件缓存,机器一吃紧就能还回去。1
所以监控上那句「这台机器内存 90%」,里面可能有一大块是随时能还的文件缓存。
你会听到:「重启就好了,重启就下来了。」「涨到 90% 也不一定有事。」
问什么:涨上去之后掉下来过吗?掉下来过,那是缓存;没掉过,堆里有东西在攒。
03 画线
那条横线是谁画的?
在容器里,是有人给这个服务写了一个内存上限,叫 limit。Kubernetes 把这个上限交给内核里管资源分配的 cgroup 去执行。4
关键在这儿:上限只对这个容器生效,机器上还有多少空闲内存,它一概不管。
机器 32G,容器上限 2G。它用到 2G 的时候,机器还有 30G 空着,它照样撑不下去。
所以碰上这件事,加机器是白花钱,把上限改大才有用。
改上限之前,得先知道线上到底用了多少。这两个数经常对不上:上限是半年前随手写的 2G,实际峰值早就是 2.4G。
你会听到:「limit 设的 2G。」「机器还很空,它怎么死的?」
问什么:上限多少、现在用到多少、最近谁改过?
04 动手
到了 2G 那一刻,它还能继续要内存。
Kubernetes 的文档把这层写得很清楚:内存上限靠「内存不够就杀」来执行,而杀只发生在内核察觉到内存吃紧的时候。超了上限的容器,一时半会儿可能一点事没有。4
真正到点的时候,内核按顺序做两件事。
第一件,回收。文件缓存这类「别处还有一份」的内存,先让出来。1
第二件,回收不出来,才轮到 OOM Killer。内核文档对它的描述很直白:为了保住整个系统,它挑一个任务牺牲掉。1
挑谁?打分。分数主要看这个进程占了多少内存,占得越多分越高;有特权的进程会被减分。5
在容器里,被停掉的通常就是那个正在申请内存的进程。如果它恰好是容器的 1 号进程,而容器被标成可重启,Kubernetes 就会把它重新拉起来。4
十点二十那件事就是这么来的:没人按按钮,重启自己发生了。上一篇算过的重启代价,从此多了一种来历。
现场的完整样子,Node.js 的文档写得很细:内存连续上涨,可能持续几天甚至几周,然后进程崩掉、被进程管理器重启,负载均衡器回 502。3
撞线之前,用户先感觉到的是慢。内存吃紧的时候,垃圾回收跑得更勤,CPU 跟着上去。3
你会听到:「OOM Killed。」「它自己重启的,我没动。」「刚才闪了一下 502。」
问什么:杀的是哪个进程?起来没有?多久会再来一次?
05 定夺
回到那三种形状,各自该按哪个按钮。
峰谷那一种,别动。 为了让曲线好看去扩容,是把钱花在一个不存在的病上。
爬坡那一种,先算速度。 一小时涨 1G,今天就得动手;一天涨 1G,你有几周。同一个毛病,速度不同,解法完全不同。
撞线那一种,先让它活着。 抬高上限或者重启,两样都是止血。血止住之后,那个问题还在原地等你排期。
工程师说「重启就好」,这句话没说错,曲线确实会掉下来。进程一退出,内核把它那块内存整块收回,漏在外面的那些对象不用一个个去找,跟着一块没了。所以重启清掉的是这一轮,不是那个毛病。他说漏的是下一句:多久它会再爬上去。
存下来当一张表
| 你听到的 | 多半指什么 | 你接着问 |
|---|---|---|
| 内存又涨上去了 | 堆里有东西被牵着没放 | 涨上去之后掉下来过吗? |
| 这台机器内存 90% 了 | 常驻内存加上文件缓存 | 里面多少是文件缓存,能还吗? |
| limit 是 2G,机器还空着 | 卡的是容器的上限 | 上限谁定的?实际用到多少? |
| OOM Killed | 撞线,被内核杀掉了 | 杀的是哪个进程?起来了没? |
| 重启就下来了 | 内存被清空 | 多久会再涨回去? |
| 要不扩容吧 | 把横线抬高,买时间 | 涨的速度是多少?还有多久撞上? |
怎么用
先看会不会回落,再看离横线还有多久。这两句有了答案,你就知道该拦、该排期,还是今天晚上盯着。
内存里那些故意留着的东西,工程师管它叫缓存。下一层从缓存讲起:为什么「加个缓存」这句话,有时候等于说「这个数可以让用户先看到旧的」。
References
- 1Linux 内核文档:内存管理概念
docs.kernel.org
- 2ps(1) 手册
man7.org
- 3Node.js 文档:内存诊断
nodejs.org
- 4Kubernetes:为 Pod 和容器管理资源
kubernetes.io
- 5proc_pid_oom_score(5) 手册
man7.org
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.