Make Grid 的巧思:先搜整个自动化系统,再看改动会撞到哪里
先用一两段说清 Make 与 Make Grid 是什么、解决什么问题,再拆两个设计巧思。

Make 是一款可视化自动化平台:用户把应用、API、数据表和 AI 组件连成场景(scenario),让重复工作自动跑起来。当团队里的场景越来越多,问题就不再是「能不能建一条自动化」,而是「整个自动化系统现在长什么样、改一处会撞到哪里」。
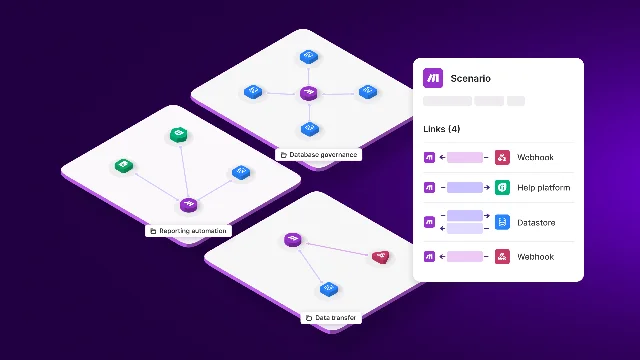
Make Grid 是 Make 为此做的系统级视图。它不是让人手动画流程图的白板,而是从账号里真实配置自动生成一张近实时依赖图,把场景、应用、数据存储和 AI 组件放到同一张地图上;用户可以浏览依赖关系、按图层看错误与资源消耗,并在改动前检查影响范围。2026 年 7 月 8 日的更新,又把搜索推进到 blueprint 内部,并开始映射 n8n、Claude 托管 agent 和 Relevance AI 等外部自动化与 AI 系统。12
Make 的官方发布文把痛点说得很具体:团队会自己定命名规则、画图、写文档,但环境一变化,手工维护的地图就开始落后。3所以 Grid 解决的不是「有没有流程图」,而是配置变多之后,没人知道一个字段、一张表或一段 prompt 到底被多少地方使用。下面拆两个设计点:搜索为什么要沉进 blueprint 内部,以及依赖图如何变成改动前的检查面。
巧思一:搜索对象的内部,而不只搜它的名字
普通的工作流目录通常只能按场景名、应用名或文件夹找东西。Make Grid 的搜索会继续进入每个 blueprint,匹配模块字段值、URL、场景备注、AI agent 的 system prompt 和依赖关系。45
这个下沉很关键。真正让一条自动化产生影响的,往往不是节点上显示的「HTTP」或「AI Agent」,而是某个字段里的 API endpoint、一段写死的提示词,或者备注中记录的临时约定。用户记得的也常常不是场景名字,而是一个 URL 片段或一句 prompt。Make 的官方例子是:团队成员在场景备注里写过一个 workaround,后来只记得其中一个词,Grid 可以直接搜出它所在的场景,不必逐个打开。4
所以,Make Grid 把「搜索自动化」从找对象变成了找配置。它不要求用户先理解整个系统的文件夹结构,而是允许用户从手头记得的碎片反向定位系统。这种入口更接近故障排查的真实顺序:先看到一个异常值,再追问它藏在哪条链路里。
代价是,搜索命中越深,结果越需要上下文判断。一个字段或 URL 可能同时出现在多个场景里,Grid 能把候选对象找出来,却不能替用户决定哪条引用应该保留。Make 的帮助文档也没有把内容搜索描述成自动修复;它提供的是定位与导航,修复仍回到具体场景和依赖对象。
巧思二:把依赖图做成改动前的检查面
很多依赖图的终点是「看起来很清楚」。Make Grid 往前走了一步:点中一个依赖后,右侧面板继续提供 Links、Attributes 和 Raw data 三种审查入口。6
- Links:看哪些场景依赖这个对象,以及它们对对象进行读取还是写入。
- Attributes:下钻到字段级别,确认某个数据库列被哪些场景引用。
- Raw data:查看依赖对象的 JSON 数据,给需要排查结构的高级用户一个更底层的核对入口。6
这三个入口把「我要换掉这张表」改写成一组可以执行的检查。官方教程用 Google Sheets 迁移到 Airtable 举例:先在 Grid 里看谁读写旧表,再看哪些属性被下游使用,然后规划新对象与字段的对应关系;现有场景仍需要由用户重新配置。6
这里的设计判断是,地图不替人改系统,而是先把改动的爆炸范围显出来。这比一个「一键替换依赖」更克制,也更适合 AI 参与的工作流:用户可以先确认某个 agent、数据表或 webhook 的影响范围,再决定是否动手。Make Grid 还提供错误标记、Need your attention 筛选,以及 Credits、Data transfer、Operations 图层,让排查不只看结构,也能看哪里出错、哪里消耗资源。45
当然,地图本身也会变复杂。Make 的文档承认,场景数量增加后,Grid 可能变得拥挤,因此提供过滤器、自动排列、文件夹岛屿和可编辑布局;界面还显示距离上次同步经过了多久,提醒用户这是一份持续更新的系统投影,而不是永远准确的静态真相。45
结尾
Make Grid 最值得借鉴的地方,不是把自动化画得更漂亮,而是把两个经常藏起来的对象放到了用户面前:配置内容和改动影响。搜索让用户从字段、URL 或 prompt 进入系统;Links、Attributes 和 Raw data 则把一张「看起来能改」的图,变成改之前可以逐层核对的工作面。
这个原则可以迁移到其他 AI 产品:只要 AI 的输出会被后续流程继续读取,产品就不该只展示最终结果,还要让用户搜到它依赖的隐性配置,并在修改前看到谁会受到影响。Make Grid 没有替用户完成迁移,反而因此保留了最重要的判断点:这次改动,究竟该不该发生。
References
- 12026 年发布说明
help.make.com
- 2Introduction to Make Grid
help.make.com
- 3
- 4How to use Make Grid
help.make.com
- 5Explore Make Grid
help.make.com
- 6Tutorial: How to replace a dependency
help.make.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.