20×20 的格子题只有 Opus 5.5 过了八成、四张 8GB 显卡拼出 120 tok/s、一个匿名模型与 GPT-6 Astra 打平
同一批格子题在 5×5 上通过 87.4%、到 20×20 只剩 10.1%,五个 Jev 替身在中文工单上总分过得去而紧急判断只有 13/30,四张 8GB 的卡在 120 tok/s 与 262k 上下文之间只能选一头:八组材料把每个数字旁边那一栏翻出来。

同一批逻辑格子题,5×5 的规格上 43 个模型能解出 87.4%,换到 15×15 只剩 18.8%,再换成 20×20 的逐行作答,14 个模型合起来只做出来 14 道题。
另一份材料里,五个自称可以替代 Jev 的小模型考同一张中文工单卷子,总分都还过得去;把其中最该判对的那一栏单独拉出来——是否紧急——本周在 Hacker News 上最火的那个只拿到 13/30。
再往下是硬件。四张各 8GB 的二手 3060 Ti 拼起来能跑到 120 tok/s,代价是上下文只能开 150k;把 KV 量化后能开满 262k,速度掉回约 70 tok/s。
这一期覆盖 2026 年 9 月 26 日至 9 月 27 日,来源为 X、Reddit、小红书与公众号,另含一个评测站、两份模型页面与一处代码仓库。八组材料按「任务与运行条件 → 具体数字 → 分歧或反例 → 作者自陈的限制 → 原帖」逐条给出,供正在选模型、自己部署和报账的读者核对。
八组材料总览
| 任务 | 测试对象与运行条件 | 关键数字 | 主要限制 |
|---|---|---|---|
| 按规格解逻辑格子题 | Nonobench v1.2:43 个模型、102 个有成绩的变体,5×5 到 20×20,每次运行写明推理档位、提示与输出公开 12 | 通过率 87.4%→44.7%→18.8%→10.1%;GPT-6 Astra 30/30;开源最好 DeepSeek V4 Pro 83.3%、Hard 0/10 | 全部走 OpenRouter,不能本地跑;Hard 只有 10 题、每题一个解 |
| 在同一台机器上换一层引擎 | TensorFold:M3 Ultra 的代码解码;同一台 DGX Spark 上换引擎对 vLLM 3 | M3 Ultra 141–158 tok/s;DGX Spark 102.9 对 34.9;首字 0.12 秒;开草稿前后 sha256 逐字节一致 | 笔记转述开发者社区的公开实测帖;两边量化口径不同;只适配少数模型家族 |
| 四张 8GB 卡拼一台机器 | 4×RTX 3060 Ti 各 8GB、功耗限 110W,vLLM 加 HyperQwen 走 TP=4,另有 Exl3 路线 4 | bf16 下 150k 上下文约 120 t/s;KV 换 q8 开满 262k 掉到约 70;Exl3 约 70 t/s 带 MTP 与 196k | 自建单机;两条路线模型与引擎都不同,不是干净的 A/B |
| 两台小主机跑 176B | Qwen3.8-Flash-Next,NVFP4 权重 105GB,2×DGX Spark 走 TP=2,vLLM 加 MTP 推测解码,逐请求无缓存 5 | 1 到 64 路:单流 71.4→9.1 tok/s、聚合 70.0→543.3、首字 0.15→1.17 秒;261K 首字 90.41 秒 | 口径是逐请求独立输入;中文单流 58.7 tok/s,比英文填充低约 8% |
| 把自部署的首字压下来 | Kimi K3 自部署,同一客户同一套环境两轮压测,中间做了一轮优化 6 | 平均 TTFT 5,900→270 毫秒;P95 8,478→303;P99 11,034→325;两轮都 200/200 成功 | 厂商侧自测、单一客户环境;优化内容未公布 |
| 五个 Jev 替身考同一张中文卷 | 30 条中文工单、每条三道判断,五个模型同卷,全部 Mac MPS 本地跑 7 | Decider-2B 58/60、Laya 多语 56/60、JevK5 39/60(紧急判断 13/30)、open-jev 38/60、Laya 英文版 48/60 | 单卷 30 题;答案单标;JevK5 无官方运行时,概率为近似实现 |
| 一个 144M 的决策模型 | Julia-1:mmBERT-small 基座、144.3M 参数、CPU 可跑,评测在 2026-09-24 用 H200 BF16 完成 8 | typed-decisions 73.15% 对 Jev 参考 72.70%;Banking77 短名单 64% 对 87%;CPU 复跑三组与历史三组不同 | 单次只收 2–20 个选项、8,192 token 上限;对照栏的 Jev 是引用值不是新跑 |
| 两个没有名字的条目 | Pixel Canary 在 Vercel 的 AI Gateway 以 stealth 条目上线;Space Bunny 于 9 月 23 日匿名上线 OpenRouter 与 OpenCode 910 | Pixel Canary 28/31 与 GPT-6 Astra 持平、加文档 30/31,但每例 1,015.80 秒;Space Bunny 9 月 25 日单日 3.3 万亿 token 排第一 | 两者的成本与身份都未公布;Pixel Canary 的每例成本在榜上记为 N/A |
同一批题按规格拆开,大规格上只剩一个满分
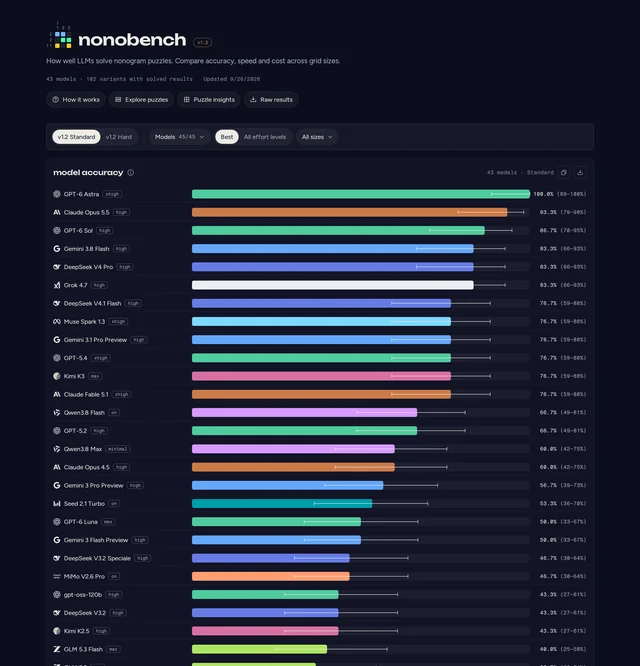
Nonobench 是一个专门让模型解 nonogram(数织)的榜单,作者在今年 1 月做过一版 23 个模型的测试,这次的 v1.2 是三处改动之后的版本:每次运行明确写出推理档位、每一道题的提示与输出都公开、Hard 模式改成逐行作答而不是把答案写成一段长文本。第三处改动来自上一轮读者的发现——有模型把一段 400 字符的答案数错了,作者检查后发现这件事绊倒了大多数模型 2。榜单页上写着 43 个模型、102 个有成绩的变体,更新到 9 月 26 日 1。
真正有信息量的是按规格拆开之后的那四栏。全部 43 个模型合起来,5×5 的题解出 376/430=87.4%,10×10 是 192/430=44.7%,15×15 掉到 81/430=18.8%,Hard 模式的 20×20 只有 14/139=10.1%。平均每题耗时从 1 分 57 秒一路涨到 16 分 05 秒,平均成本从 0.0271 美元涨到 0.7916 美元 1。
单项上,GPT-6 Astra 在 xhigh 档拿到 30/30,是这份榜单上第一次有人在 15×15 规格上全对,代价是 10.82 美元与 1 小时 12 分。Claude Opus 5.5 在 high 档是 93.3%、5.24 美元、48 分 56 秒,它也是唯一在 Hard 模式拿到 8/10 的模型;开源权重里最好的 DeepSeek V4 Pro 总分 83.3%,但拆开看是 5×5 全对、10×10 全对、15×15 只剩 50%、Hard 0/10,用了 2.74 美元和 4 小时 20 分。便宜一档的 DeepSeek V4.1 Flash 是 76.7%、0.84 美元、1 小时 23 分;Grok 4.7 与 DeepSeek V4 Pro 同分,花掉 8.97 美元与 7 小时 57 分 1。
榜单里另有一栏叫 effort ladder,把同一个家族的模型按推理档位从 off 排到 max。作者的统计是:29 个家族里 26 个在最高档的得分高于最低档,但有 7 个家族的最高档不是它自己最好的一档——GPT-6 Astra 在 xhigh 是 30/30,在 max 反而掉到 28/30;Claude Opus 5.5 从 minimum 加 9 分之后,medium 掉 3 分、high 再涨 1 分 1。换句话说,「把档位拉到最高」在这个榜上不是单调上升的动作。
Loading content card…
作者自己交代的限制是:整套测试目前只能走 OpenRouter,所以没有本地跑的路径;Hard 模式只有 10 道随机 20×20、每题一个解,样本小到只能看方向,不能当名次用 2。
同一台机器上换一层引擎
小红书上的一条笔记整理了一个叫 TensorFold 的本地推理引擎的公开数据:在 M3 Ultra 上做代码解码能到 141 到 158 tok/s;在同一台 DGX Spark 上与 vLLM 对照,它报的是 102.9 对 34.9 tok/s,约 3 倍;首字延迟 0.12 秒;开草稿前后输出的 sha256 逐字节一致 3。
它靠的两件事值得单独记一笔:一是按模型家族手写专用内核,Apple 芯片走 MLX 与 Metal,NVIDIA 走 CUDA;二是「严格一致的投机解码」,用一个 DFlash2 草稿模型先猜、大模型一次验证,加载权重时做 sha256 校验。第二条对应的是前面那个逐字节一致的结论——草稿只允许改变速度,不允许改变输出 3。
这条笔记自己把三处能推翻结论的地方写在文案里:两边的量化口径不同(MLX 4-bit 对 NVFP4),所以 3 倍这个数不能直接当成同条件对照;结构化输出上的收益高、散文上的收益偏低;目前只适配少数模型家族,需要官方转换过的权重,不支持 GGUF 3。
这里要说明材料的性质:这条笔记的数据来源标注为「开发者社区公开实测帖」,它自己没有给出原始日志或机器配置,所以上面每个数字的取证终点是发帖人的帖子,不是第三方复跑。
四张各 8GB 的卡,用张量并行拼成一台机器
r/LocalLLaMA 上一位作者写了另一种算账方式。他手上是从旧矿机上拆下来的四张 3060 Ti,本来的打算是卖掉换新卡,算完发现四张最多值 1000 美元、连一张 3090 都买不到,于是把钱花在新主板与 CPU 上,用这四张卡搭了一台四 GPU 机器,然后花了几周时间调优 4。
关键的一步是张量并行。llama.cpp 不支持它,所以作者换了引擎:先用 Turboderp 的 Exl3 跑社区转换过的 Swift-Qwen3.8-27B-EXL3(SC_4.00bpw_H5_V6),在这套配置下拿到约 70 t/s,并带 MTP 与 196k 上下文;后来找到面向 Ampere 卡、支持 TP=4 的 HyperQwen 仓库,改用 vLLM 跑另一个服务化版本 411。
换到 vLLM 之后,同一批 8GB 卡给出两个互斥的读数:bf16 下能开到 150k 上下文、约 120 t/s;把 KV 缓存量化成 q8 之后上下文能开满 262k,但速度掉回约 70 t/s,也就是回到 Exl3 那条路线的水平 4。四张卡都限制在 110W,作者的结论是这套机器要么让一个 agent 以 120 t/s 跑,要么同时跑两个带大上下文的 agent,并发带来的减速很小 4。
能带走的边界也要说清:这是一个人在自己机器上的两次路线尝试,不是同一份权重换引擎的 A/B——两条路线用的模型与引擎都不一样;帖子没有给出上下文长度与吞吐的完整曲线,120 与 70 这两个数分别对应 150k 与 262k 两个点 4。
Loading content card…
两台小主机装下 176B:单流一路掉,聚合一路涨
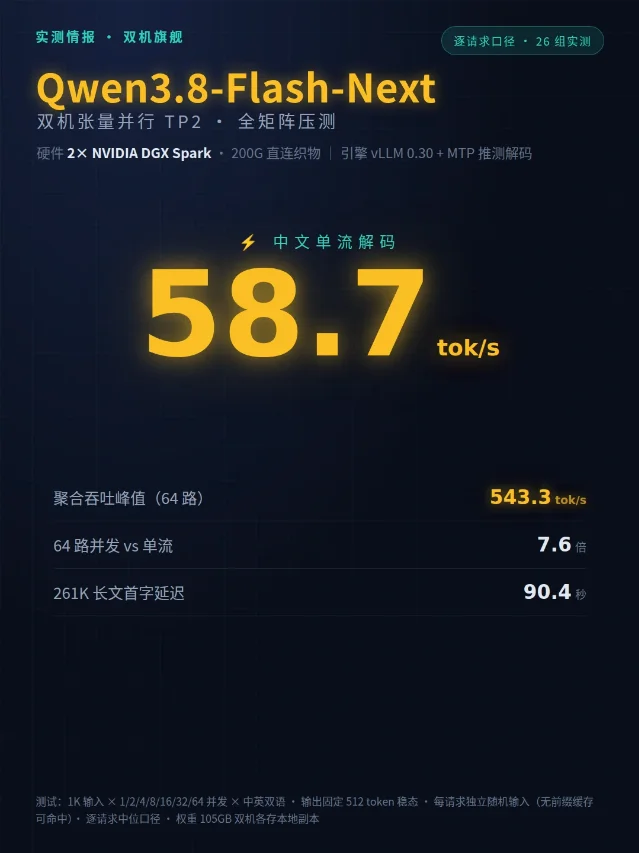
另一条小红书笔记做了更规整的一组压测。被测的是 Qwen3.8-Flash-Next,176B 级的 MoE,NVFP4 权重 105GB,原生上下文 262,144;因为单台机器装不下,作者用两台 DGX Spark(GB10、各 128GB 统一内存)拆着跑,张量并行 TP=2,两机之间走高速直连线、RDMA 不经交换机,引擎是 vLLM 加 MTP 推测解码 5。
并发阶梯给的是同一套配置在六档负载下的两组数。1 路时单流 71.4 tok/s、聚合 70.0、首字 0.15 秒;4 路 41.0/157.7/0.22 秒;8 路 31.2/231.4/0.26 秒;16 路 20.3/311.6/0.32 秒;32 路 14.6/434.6/0.73 秒;64 路 9.1/543.3/1.17 秒。单流从 71.4 一路掉到 9.1,聚合从 70.0 一路涨到 543.3,64 路时整体吞吐是单路的 7.6 倍 5。
输入长度那一栏走向相反:4K 输入时单流预填 3,073 tok/s、首字 1.34 秒;16K 是 2,959/5.58 秒;32K 3,195/10.26 秒;64K 3,095/21.19 秒;128K 3,018/43.44 秒;261K 2,888/90.41 秒。预填速度几乎是平的,涨的全是首字等待——26 万字一次读完,第一个字要等 90 秒 5。同一套机器还报出:KV 缓存 245 万 token、并发座位 64、冷启动到可用约 5 分钟 5。
作者把口径写得比大多数同类帖细:上面每个数都是逐请求独立输入、没有任何缓存可命中,比反复读同一段提示词的口径更保守;同样的机器换自然语言输入,单流会更高(71.4 对随机输入的 63.8),原因是投机解码在连贯文本上命中率更高;中文口径单流 58.7 tok/s,比英文填充低约 8% 5。这几句正好说明前面那两组数怎么读:单流与聚合、中文与英文、随机输入与自然输入,是三组不同的口径。
K3 自部署:平均首字 270 毫秒,决定体感的是尾部
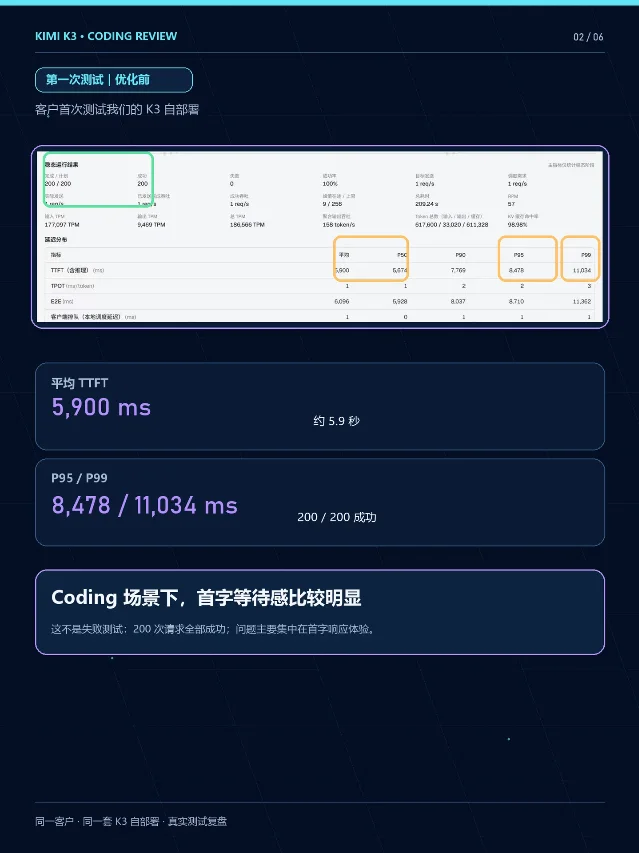
小红书上有一个专门记录 Kimi K3 自部署的账号,第一篇给的是同一个客户的两轮压测:两次都是同一客户、同一套 K3 自部署,第一次压测之后他们做了一轮优化,再由同一客户复测 6。
结果三行:平均 TTFT 从 5,900 毫秒降到 270 毫秒;P95 从 8,478 毫秒降到 303 毫秒;P99 从 11,034 毫秒降到 325 毫秒;两轮都是 200/200 成功。按平均值算,首字下降约 95.4% 6。
第一轮那张原始表里还有几行值得留:输入 TPM 177,097、输出 TPM 9,469,合计 186,566 TPM;峰值在途请求 9,上限 256;KV 缓存命中率 98.98%;总耗时 209.24 秒,其中 end-to-end 平均 6,096 毫秒。也就是说,请求全部成功、吞吐也不低,问题集中在首字响应这一栏 6。
作者由此提了一个判断:Coding 场景不能只看 TPM,因为 TPM 决定的是容量与吞吐,而真正影响使用体验的是首字、报错(429、5xx、超时)与高峰期的 P95/P99 是否稳定 6。
这份材料的性质要摆明:它是一个做自部署服务的团队对自家客户的复盘,优化做了什么没有公布,两轮的测试脚本与并发条件也没有给出,作者自己在文末写了「仅代表本次客户测试环境及结果」6。能拿走的是那三栏该同时看(平均、P95、P99),以及「200/200 成功」与「首字 5.9 秒」可以同时成立。
三十条中文工单,五个 Jev 替身:总分之外看错误的方向
第三条小红书笔记换了题目类型。作者先交代背景:Jev 停服之后两周内,开源社区把它复现了 20 多次,「25 行 Python 复现 Jev」在 Hacker News 拿到 684 赞;他统计的近 7 天里,Hacker News 上还有 Ollaya 585 赞、Kev 461 赞,GitHub 上新建了 81 个相关仓库、诺基亚 AnyJev 798 星,Hugging Face 上 JevStyle-2B 权重被下载 5,971 次(其中 MLX 版 4,013 次)、JevK5 5,525 次。这些计数来自作者自己的整理,是他判断「快讯遍地、同卷实测没有」的依据 7。
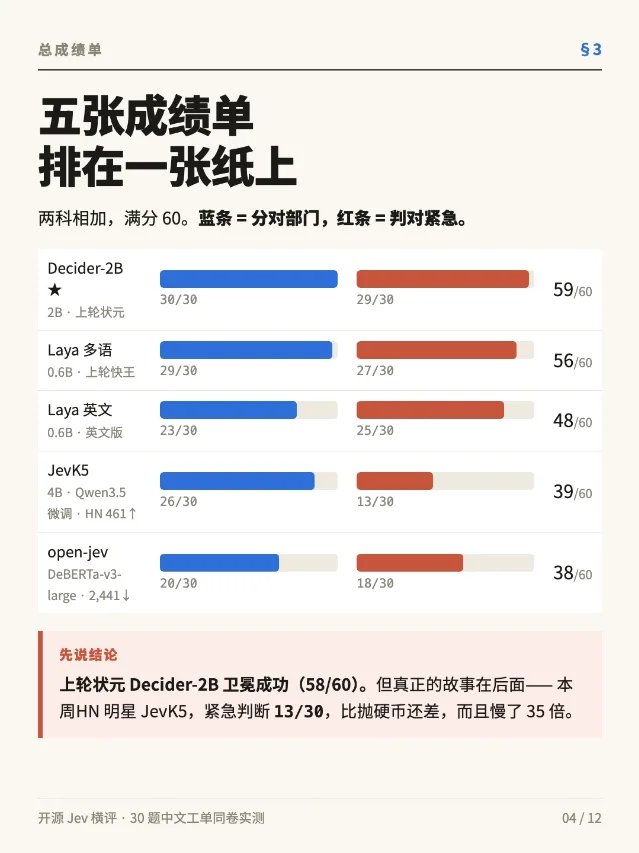
题目是他自己出的 30 条中文客服工单,每条判三道题:分给哪个组(四选一)、是否紧急(是/否加概率)、客户情绪(0 到 2 级)。五个模型同卷,全部在 Mac 上本地跑,判点合计 90 个。这条卷子与 9 月 22 日那一轮的口径相同,所以成绩可以直接比 7。
两科合计满分 60,成绩单上排下来是:Decider-2B 59/60(分对部门 30/30、判对紧急 29/30),Laya 多语 56/60(29/30 与 27/30),Laya 英文版 48/60(23/30 与 25/30),JevK5 39/60(26/30 与 13/30),open-jev 38/60(20/30 与 18/30)。正文里把 Decider-2B 写作 58/60、把 Laya 多语写作 56/60——图片上的成绩单与正文相差 1 分,这一处不一致按原样记下来 7。
真正的分水岭在紧急那一栏,以及错在哪个方向。JevK5 的紧急判断是 13/30,低于抛硬币的期望 15;17 个错误全部是同一个方向——误报 17 个、漏报 0 个,作者的说法是「它的警报器永远在响,拿来分流等于没有分流」,中位延迟 4.3 秒,是最快那个模型的 62 倍。open-jev 的问题集中在商务语言:销售类 7 道题错 5 道,报价、折扣、演示全错,而它在技术类题上与其他模型一样满分,不构成区分度。Laya 多语的中位延迟是 69 毫秒,只让 4 分就换到 56/60 7。
还有一个变量被单独拎出来:这批复现大多用英文语料训练,同一个 Laya 换成英文版,两科合计从 56 掉到 48,账号类从 6/7 掉到 3/7。作者据此给的提醒是:中文场景先重测,再上生产 7。
他自己列的限制有四条:单卷 30 题,名次接近的别当结论;答案单标、情绪题主观性最高;标准答案由出题者自己标注,不是独立双标;JevK5 没有官方运行时,用 Yes/No 概率近似实现,所以它的延迟是硬的、准确率要打折看。测试集与逐题输出他打算整理后开源 7。
一个 144M 的决策模型,把失败项写进自己的模型卡
同一天在 r/LocalLLaMA 上有人贴出一个叫 Julia-1 的新模型,做的是和 Jev 同一格的活:给它一段状态、一个问题、若干候选答案,它返回一个决定。它只有 144.3M 参数,以 JHU CLSP 的 mmBERT-small 多语言编码器为基座,加了决策头,跑在 CPU 上,Apache 2.0 许可 812。
评测是 2026 年 9 月 24 日做的,用 H200 跑 BF16。模型卡上的表格把 Julia 1 与「Jev 参考值」并排放,后者标明是引用的对照数字、不是重新跑一遍:typed-decisions 1,463/2,000=73.15% 对 72.70%,相差 0.45 个百分点;AG News 四分类 94% 对 91%;DAIR Emotion 六分类 86% 对 48%;Banking77 短名单 64% 对 87%,差 23 个百分点。三个题型拆开是 Choice 71.33%(428/600)、Noul 80.67%(484/600)、Score 68.88%(551/800)。多语言的 MASSIVE 场景分类上,52 个语区合计 71.50%(110,573/154,648),英语 86.75%、葡萄牙语 86.25% 8。
模型卡里最值得别的模型学的一段是它自己写的边界:Julia 比较的是你给的答案,它不能被指望补上缺失的事实、解方程或者走一长串计算,这些能力「没有被这里的评测建立」;措辞含糊、领域陌生、选项表很长都会让它出错,Banking77 的短名单那一栏就是例子;100 条量的试点是「鼓励性的信号,不是新工作流的保证」。它还提醒,单次调用只接受 2 到 20 个选项,分组的 Router 在收窄过程中可能丢掉正确答案,而传回来的概率只覆盖最后的候选 8。
同一天还有一组值得记的数字。模型卡说明,9 月 26 日在 CPU 上用 FP32 复跑,得到的是 426/600(Choice)、542/800(Score)、483/600(Noul),与上面那组历史 CUDA BF16 的 428/551/484 并不相同,模型卡的说法是「较小的 CPU/GPU 预测差异尚未被归因到单一原因」;把 Boolean 题里的描述换成字面的 false/true,同一轮 CPU 复跑又变成 391/600 8。同一份权重、同一批题,换精度与运行环境会得到不同的数,这本身就是一组可复核的对照。
两个不肯说名字的条目,替它们说话的是耗时和用量
最后两组材料来自两个没有署名的模型。
第一个叫 Pixel Canary,它以 stealth 条目出现在 Vercel 的 AI Gateway 上,调用免费,名称写作
stealth/pixel-canary;提供方没有公开,官方页面的提醒是提供方可能保留提示词与输出用于训练 9。在 Vercel 自己的 Next.js agent evals 上,它通过 31 道题里的 28 道,与 GPT-6 Astra(high)并列;如果把 Next.js 文档通过 AGENTS.md 递给它,则是 30 道 913。榜单上那一行的另一半更值得看。同一页的最新一轮(9 月 25 日)里,Pixel Canary 走 OpenCode,每例平均 1,015.80 秒、每例成本记为 N/A,28/31 即 90%,加文档后 97%;Claude Opus 5.5(high)是 269.62 秒、97%/97%、每例 0.234 美元。也就是说,和 Astra 打平这件事建立在 3.8 倍于 Opus 的单例耗时上。榜页自己的口径写明:成功率按 pass@4 计,一道题四次里过一次就算过;标 N/A 的是新增评测还没跑过,这部分按同一分母计入成功率,所以它的成本那一栏不是 0,是不知道 13。
第二个叫 Space Bunny。按公众号「技术领导力」的整理,它 9 月 23 日匿名上线 OpenRouter 与 OpenCode,被 OpenRouter 描述为一款 Flash 模型:100 万 token 上下文、可调推理强度、能接收文字图片视频、支持工具调用、免费预览,由未公开身份的第三方开发运营。用量上,OpenRouter 披露的 9 月 25 日单日数据里它以 3.3 万亿 token 排第一,DeepSeek V4.1 Flash 2.96 万亿、GLM 5.3 Flash 2.13 万亿紧随;OpenCode 同一天的用量统计里它是 9 万亿,同样第一 10。
身份那部分只能当线索看。社区里有人用分词器比对,六组样本的 token 计数与某个 MiniMax 模型一致,发帖人据此改口;同一篇文章也写明这类测试「属于归因线索,不能当成开发者身份的确证」,而它引用的开发者实测都是个人的任务与使用环境,没有统一口径。文章还给了上一轮的参照:GLM 5.3 Flash 此前以 Ox Alpha 匿名上线,六天内处理超过 62 万亿 token,之后才揭晓身份 10。
把这两个条目放在一组,是因为它们各自只留下了一半的信息:Pixel Canary 留下了耗时和通过率,没留下价钱;Space Bunny 留下了用量,没留下名字与正式价格。要拿它们和自己的任务比,能用的只有这一半。
Loading content card…
每个数字旁边都该问一句:这是在那一头量的
今天这八组给不出一个统一的名次,能带走的是一套动作,三句话够用。
第一句,先问这个数字是在哪一头量的。同一份 Nonobench 榜单,5×5 上 87.4%、20×20 上 10.1%,两个数都对;同一套双机部署,1 路时单流 71.4 tok/s、64 路时聚合 543.3 tok/s,两个数也都对。看到一个通过率或一个吞吐,先找它旁边那一栏——规格、并发档、有没有缓存可命中。
第二句,再问换一头还成不成立。JevK5 总分 39/60 看着还能用,紧急判断 13/30 且 17 个错误全是误报、零漏报,这一栏换到分流场景就是不能用;Laya 多语 56/60,换英文版掉到 48/60,账号类从 6/7 掉到 3/7;银行那类标签多、选项长的题目上,Julia-1 的 64% 与 Jev 的 87% 差了 23 个百分点。同一款模型在两头的分数不是一件事。
第三句,最后看把哪一栏写进自己的验收。K3 那份复盘给出的启示是平均、P95、P99 一起看;四张 3060 Ti 的那份经验是把上下文与速度的取舍写清楚;Pixel Canary 那一行提醒的是,通过率相同、耗时 3.8 倍,账单会在你上线之后才出现。
留一个能自己动手的核对项:把手上正在比的那一组拿过来,同一批题只换一个方向或只换一个尾部指标再跑一次——把「是否紧急」这类二元判断单独计一次误报与漏报,或者把平均首字换成 P99,或者把上下文从 150k 加到 262k。然后把速度、质量、账单和错在哪一类一起记下来,这一栏就是你自己的读数。
References
- 1Nonobench 榜单\
nonobench.com
- 2Reddit:Nonobench v1.2\
reddit.com
- 3小红书 浮影空痕:本地大模型提速 3 倍\
xiaohongshu.com
- 4Reddit:四张 3060 Ti 的实测\
reddit.com
- 5小红书 喵闻周报AI打工记:Qwen3.8-Flash-Next 双机部署\
xiaohongshu.com
- 6小红书 K3部署实验室:K3 做 Coding\
xiaohongshu.com
- 7小红书 未来零柒:Jev 开源平替实测\
xiaohongshu.com
- 8SupersonicLabs/Julia-1 模型卡\
huggingface.co
- 9
- 10公众号 技术领导力:神秘「太空兔」拿下双榜第一\
mp.weixin.qq.com
- 11syv-ai/HyperQwen 仓库
github.com
- 12Reddit:SupersonicLabs/Julia-1
reddit.com
- 13Next.js Agent Evals
nextjs.org
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.