一份 1991 年的技术报告:ChatGPT 的 P、位置编码与蒸馏,功劳该算给谁
一份 1991 年的慕尼黑技术报告被主张写了 ChatGPT 的 P、位置编码与知识蒸馏;本期把这场从 10 月 6 日烧到 10 月 8 日的功劳之争按时间理清,并打开那份被点名的报告逐项核对。

北京时间 10 月 8 日 14:00:38,Yann LeCun 在 X 上发出这样一条帖:「少数科学家有一种奇怪的(而且多少有点自利的)癖好,想把全部功劳都推给那个提出含糊想法的人——把它发表在一份不起眼的技术报告上,没有理论,谈不上什么实验验证,三十年来也没有后续工作。」十九秒后他补上第二条,只有三个词:「Not a helicopter.」(不是直升机。)12
这两条帖是这轮争论到发稿时最新的一对。争的是这行分配功劳的方法本身,而不是哪一个模型更强。
而在整轮争论里,只有一份文件被点名、被给出链接、可以被打开。
01 先把账按时间理清
源头不是 LeCun。
10 月 6 日 22:10:08,Jürgen Schmidhuber 先发了一帖:「我 1991 年的论文引入了三项对现代大语言模型至关重要的技术:★ 深度神经网络的预训练——ChatGPT 里那个 P;★ 位置编码(第 5.1 节);★ 把知识蒸馏进神经网络(第 3.2.2 与第 4 节)。」3
他在帖里给出了那份文件:[1] Neural sequence chunkers. TR FKI-148-91, TUM, April 1991——慕尼黑工业大学的一份技术报告;并附上期刊版出处:Neural Computation 4(2):234–242, 1992。3 到本篇发稿,这条帖有 3.3 万次浏览与 328 个赞。
一个半小时后,风向变了。
10 月 6 日 23:41:27,Russ Salakhutdinov 发了一条吐槽:「关于(部分)AI 研究者与学者的趣事:你资历越深,就越确信每一个新的 AI 想法都是你二十年前就发明过的。或者更妙——等某个东西真的做成了,再去说服所有人这正是你一直在说的。我在一个会议上,讲者正在报告。一位学者站起来说:你做的其实是我几年前就做过的。讲者很有礼貌地说了谢谢。然后第二位研究者站起来说:我十年前就做过了,你该引我的工作。然后第三个人说:这些我二十年前全做完了。那是我见过最好笑的事。」4
Salakhutdinov 不是无关的旁观者。他主页上写的身份是卡内基梅隆大学教授、Sooth Labs 首席科学官、ICML 理事会候任主席,以及「前 Meta 研究副总裁(多模态大模型与 AI 代理)」。4 这条帖到发稿有 11.6 万次浏览、1159 个赞,是整轮里热度最高的一条。
这条帖没有点名。回复区里,有人把名字填了进去。
10 月 7 日 00:50:22,Justin Chen 写:「剧情反转:故事里站起来的这三个人都是 Schmidhuber。」5
10 月 7 日 01:15:30,做强化学习与机器人的研究者 Frank Röder 反问:「好笑。可你究竟把它做成了吗?想法可以很便宜,执行要难得多。」6
10 月 7 日 06:55:09,Amazon 应用科学家实习生 Saksham Jain 顺着这个句式补刀:「那个 2003 年的版本永远是一篇四页的 workshop 短文,没有代码,配一张糊掉的图,哈哈。」7 他说的「2003 年的版本」,指的是每次有人出来认领时被翻出来的那份旧文献——LeCun 两天后接的就是这个句式。
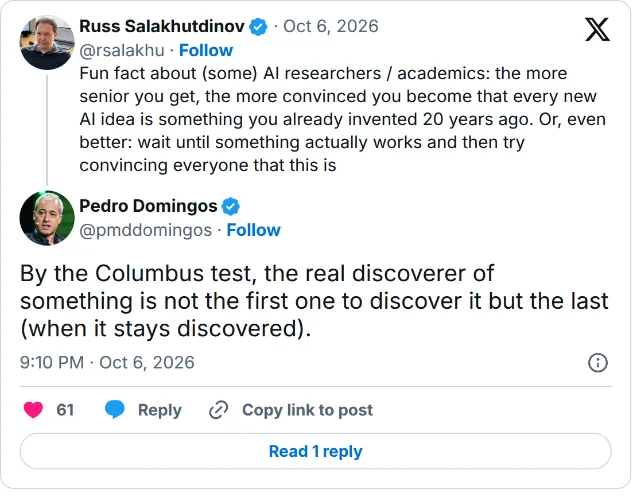
10 月 7 日 05:10:47,华盛顿大学计算机科学教授、《The Master Algorithm》作者 Pedro Domingos 给出了整条线程里唯一一条成型的、可以引用的判定规则——而且它和 LeCun 的规则正相反:「按哥伦布检验,一件事真正的发现者不是第一个发现它的人,而是最后一个(当它就此留下来的时候)。」8
然后 LeCun 进来了。
10 月 7 日 19:25:42,他回复 Jain 那句玩笑,写下了这轮争论里被转述最多的一段:「那个 1991 年的版本,是一份不起眼的技术报告,一个含糊的想法,没有理论,谈不上什么实验,肯定也没有代码,作者此后再没碰过、也没推过。它只有一张手绘的架构图、一个形如 f(x)=0 的公式,以及一个主张:只要你把 f 和 x 适当地实例化,其他所有技术都是它的特例。」9
十五分钟后,他回复 Röder,给出了那个后来被反复转述的类比:达·芬奇没有发明直升机,科努 1907 年造出的机器离了地,路易·布雷盖发明了斜盘,福克在 1936 年飞成了带对转旋翼的可控直升机,而西科斯基 1939 年用可变桨距尾桨把它变得实用;「拿到基本想法是最容易的部分。把它造出来更难。让它真正工作最难。」10 这两条帖分别有 6.1 万与 4.8 万次浏览。
10 月 8 日 07:43:33,一个日常只发西班牙语足球与政治吐槽的账号贴出维基百科的引文,主张旋翼机 1923 年 1 月就在马德里首飞,并说「旋翼机被认为是现代直升机的先驱」。11 这个事实主张本身是对的:胡安·德拉谢尔瓦的旋翼机 1923 年 1 月在马德里一带完成首次有记录的飞行。12 但按权威定义,旋翼机与直升机的分界就在旋翼是否由发动机驱动,所以它不是直升机——LeCun 那句「Not a helicopter」在事实上站得住。
10 月 8 日 10:50:03,一位只有四个粉丝的账号追问:为什么科学家们不承认这个事实,是不是失败的自尊在说「本来站在讲台上讲话的应该是我」。13 14:00:38,LeCun 回复了他,就是本篇开头那条「自利的癖好」。1 14:45:20,Röder 补充说明自己的立场被二元化了:他说的是想法「可能」便宜,不是说所有想法都便宜。14
从头到尾,被指控的那个人没有出现在这条线程里。 Schmidhuber 在同一个窗口照常发他自己的主张:10 月 7 日 00:16:47,他回复另一位用户说,「关于 ChatGPT 里那个 T:再早一个月,1991 年 3 月,就有了第一种 Transformer——未归一化的线性 Transformer(ULTRA)。」15 两人的帖子落在同一条线程里,却没有任何一条是发给对方的。
02 被点名的那份报告,长什么样
LeCun 那条帖没有点名任何一份报告,也没给链接。没有对象的描述无法被检验,能检验的只有被点名的那一份。
下面先看这份实物,再回头看那段话与它对得上多少——那不是判定,只是一次对照。
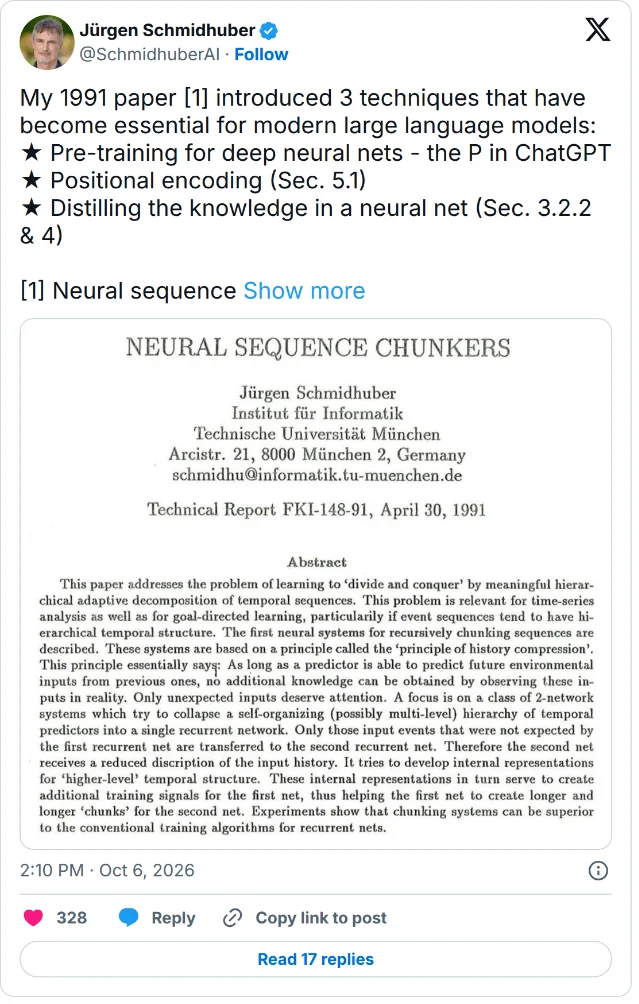
那是 FKI-148-91《Neural Sequence Chunkers》(神经序列分块器),署名 Jürgen Schmidhuber,慕尼黑工业大学信息学院,落款「Technical Report FKI-148-91, April 30, 1991」,正文 17 页。16
报告是真的,他引的三个节号也是真的。摘要讲的是「历史压缩原理」:只要能预测未来的输入,观察这些输入就不再带来新知识,只有意外输入值得注意;据此搭一套两个循环网络的系统——一个 automatizer 负责预测,一个 chunker 只接收预料之外的输入。16 他点名的第 3.2.2 节标题是「把预测器层级压进单个网络」,第 4 节是「一个双网络分块系统」,第 5.1 节是「时间步与关键时刻的各种表示」。16
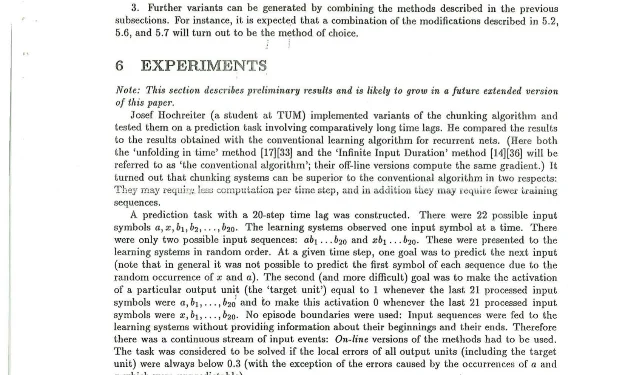
然后是实验。有,实验在第 6 节,但它开头有一段作者自己加的话:「注意:本节描述的是初步结果,本论文将来的扩充版很可能还会有增加。」16
接着是署在实验下面的人:「Josef Hochreiter(慕尼黑工业大学的一名学生)实现了分块算法的若干变体,并在一个含较长时滞的预测任务上做了测试。」16 致谢里再写了一次:「我要感谢 Josef Hochreiter 执行了这些实验,并对本论文初稿提出了有用的意见。」16 这位 Josef Hochreiter 后来以 Sepp Hochreiter 之名署名,是 1997 年那篇 LSTM 论文的第一作者。17
实验做了什么,报告也写得很具体:一个 20 步时滞的序列预测任务,22 个输入符号,只有两条可能的输入序列随机出现。作为对照的常规循环网络在 100 万条训练序列后仍未能解出,被中断;分块系统解出了任务,17 次试验中 13 次在 5000 条训练序列以内让目标单元误差稳定下来。16
报告里没有的东西也值得说清楚。
没有代码。 全文没有源码、没有伪代码清单,实现由 Hochreiter 完成,代码不在报告里。16
没有定理。 有「时间上局部」「空间上局部」这类定义与误差函数的推导,但没有定理、没有证明、没有收敛性分析;作者在 4.2 节自己写下:基于在线权值更新的分块系统,「我们目前无法证明它总会如期望那样工作」。16
没有架构图。 18 页(含封面)里没有任何插图、示意图或流程图——不是一张手绘,是零张;chunker 与 automatizer 的结构只在 4.1 节用文字描述。16
也没有 f(x)=0。 全文唯一的 f(x) 是第 6 节的 logistic 激活函数 f(x)=1/(1+e^−x);其余是若干误差与状态方程。16
把 LeCun 那段描述拿去逐项对这份实物:「没有代码」对得上;「没有理论」半对(有定义与论证,没有定理);「谈不上什么实验」对不上(第 6 节有,还有量化结果);「作者此后再没碰过、也没推过」对不上(1992 年出了期刊版,本人此后三十多年一直在推);「一张手绘架构图」对不上(零张);「一个 f(x)=0 的公式」对不上。
这一步不构成对 LeCun 的判定——他没有指认过对象,那段话也可能指向任何一份他记得的旧报告,本刊不去替他认领。它只说明一件事:一段没有对象的批评,读者没有办法自己动手检验。
03 三项主张,逐项核
回到被点名的那一份。它到底有没有写出那三项技术?逐条看。
先说一个共同的发现:这份报告从头到尾没有出现「预训练」(pre-training)、「位置编码」(positional encoding)、「蒸馏」(distillation)这三个词中的任何一个。 它用的是 collapse(坍缩、压进去)和 compressing(压缩),三个术语都是三十多年后回头套上去的名字。这一点决定了这类主张该怎么判:不能用「文中是否出现该术语」来判,只能用「文中那套机制是否就是今天那件事」来判。
第一项,预训练——也就是「ChatGPT 里那个 P」。 报告里对应的是第 3.2.1 节:逐层搭起更高层的预测器,每一个都被训练来预测自己的下一个输入,只有下层预测不了的输入才往上送。16 这就是后来所说的无监督/自监督预训练在结构上的雏形。
但把它叫「预训练」,是 Schmidhuber 后来的命名。他 2021 年起的个人页面上,这项工作的标题是「1991:首次用无监督预训练做非常深的深度学习」。18
独立一侧的记录方式不同:那几篇被后来者当作权威的文献,把节点记在别的年份。JMLR 上那篇系统研究无监督预训练的论文,把「有效训练深层架构的突破」明确定在 2006 年,指的是深度信念网络与堆叠自编码器那一批工作,并把整套做法概括为「贪心逐层无监督预训练,随后有监督微调」。19 Bengio 等人的分层预训练论文与 2013 年那篇表征学习综述,同样把节点记在 2006 年,并把更早的铺垫追到 1994 年的自编码器。2021 三篇的参考文献里都没有那份 1991 年报告。
第二项,位置编码。 报告第 5.1 节确实在解决「怎么唯一地表示一个时间步」,并且给了一个具体做法:把 s(t) 设成 1/t。16 Schmidhuber 本人在 10 月 6 日回复另一位用户时也解释过,1991 年的做法是带 1/t 时间衰减的偏置。22
而在紧挨着这个公式的下一句,报告自己写了它的毛病:「在神经网络的语境里,这种唯一时间表示的问题是,如果时滞很长,它可能不太好用,因为很不同的时间步会有非常相似的表示。」16
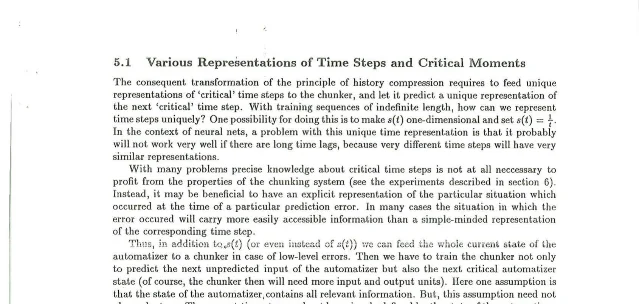
今天所说的位置编码,权威出处是 2017 年那篇 Transformer 论文的第 3.5 节;它给出的正弦式与可学习式两类选择,只引了一篇 2017 年 5 月的卷积序列模型论文。23 那篇 Transformer 论文的参考文献里确实有 Schmidhuber,但两处分别是 1997 年的 LSTM 与 2001 年关于梯度流的文章,与位置编码无关。23
第三项,蒸馏。 三项里,这一项在报告中留下的痕迹最实。第 3.2.2 节的三步循环,第三步是「训练下层预测器,去复现上层预测器有意义的内部状态」;第 4.2 节把它称为「坍缩操作」,并写明 automatizer 会被训练去复现 chunker 的内部表示。16 这就是把一个网络的内部表示搬到另一个网络里去。Schmidhuber 在 2025 年 11 月写下的专页里,把这项列为「神经蒸馏」的首次发表,并指控 2015 年那篇经典蒸馏论文没有引用 1991 年的原始出处。24
2015 年那篇论文把先驱功绩明确归给了另一组人:它写这套策略「已经由 Rich Caruana 及其合作者开创」,引的是 2006 年那篇关于模型压缩的会议论文。25 2006 年那篇的参考文献里也没有 Schmidhuber。26
三项核完,结论是同一种:这三项主张都不是凭空来的,但它们挂的都不是 1991 年那个名字。 1991 年那份报告确实跑在一个当时没有人这么做的方向上;今天这三样技术也确实用了同一类机制。争议不在于它们是不是同一类机制,而在于该按哪条规则把这份功劳记到 1991 年。
而这条规则,这个领域没有。
04 为什么这件事没有裁判
这行没有优先权仲裁机构。
没有哪个学会、哪份期刊、哪个委员会负责裁定「谁先」。能起作用的东西只有三样——奖项、引用、以及圈内记忆——它们都在事后很久才结算,而且都不受理争议。Domingos 那句哥伦布检验,8 和 LeCun 那句「让它真正工作最难」,10 是两套不同的记账法,但没有任何一方有权把账结掉。
这两种记账法也不是这轮才有的。
Robert Merton 1961 年写过「科学发现中的单一发现与多重发现」,指出多个研究者各自独立做出相似发现才是科学的常态;1968 年又写了「科学中的马太效应」,说明已成名者会拿到与贡献不成比例的名声,这种情况在合作中、以及在不同等级研究者各自独立做出同一发现时最明显。27 更晚一条常被引用的说法是 Stigler 定律:「没有任何科学发现是以它最初的发现者命名的」——这句话本身还带着自指,因为 Stigler 把这条定律的发现权归给了 Merton。28
也就是说,功劳不按贡献分,是半个多世纪前就被写下来的现象,不是谁的道德问题。
真正让这轮争论变得特殊的,是其中一方把账做成了清单。
Schmidhuber 那份技术报告《三位图灵奖得主如何重新发表了他们未曾致谢的他人方法与想法》,当前版本更新到 2026 年 5 月 31 日,逐条列出与 Bengio 的 7 项、与 Hinton 的 6 项、与 LeCun 的 4 项优先权争议。29 其中四项就挂在这份 1991 年报告上:H1 是无监督预训练(他记的是 1991 年对 2006 年),H2 是神经网络蒸馏(他记的是 1991 年对 2015 年),另两项是时间尺度层级与多层抽象。29
这条线也不是从 2026 年才开始的。2024 年诺贝尔物理学奖授给 Hopfield 与 Hinton 之后,30 Schmidhuber 写过一份题为《一个剽窃的诺贝尔奖》的报告,并配帖直斥「现代 AI 没有一个重要算法是 Hopfield 与 Hinton 创造的」。31 2018 年那届图灵奖由 LeCun、Hinton、Bengio 三人分得,正是这份清单的靶心。
这行对这件事还有另一种反应:把它做成笑话。 2026 年的一篇恶搞论文提出了一个「Schmidhuber 分数」,用来量化一篇 AI 论文有多大比例的想法可以归到 Schmidhuber 实验室,在 11 篇论文上取得均值 0.8970,并称系统「完全由一个 CLAUDE.md 配置文件实现」,是「以每项归属的代码行数衡量最高效的代理架构」。这是篇讽刺作品,不能当结论引;但它记下了一件事——这套论证方式在这行已经成为一个固定的梗。32
05 为什么是现在
这轮争论之所以在这个时间点变激烈,是因为两人站到了同一条技术路线上。
LeCun 在 X 简介里写的身份是 AMI Labs 创始人兼主席、纽约大学教授、前 Meta 首席 AI 科学家、图灵奖得主。1 而 Schmidhuber 在那份「谁发明了 JEPA」的技术笔记里,把 LeCun 的联合嵌入预测架构称为 LeCun 新公司的核心,并写道这套东西「本质上与我们的 1992 年可预测性最大化系统相同」——等于把 AMI Labs 的卖点直接划进自己 1992 年的账。33
Schmidhuber 这边也有新动作。2026 年 9 月 24 日,他加入 Sakana AI 任首席科学顾问,并进入该公司的递归自我改进实验室;这是兼任,他同时保留原有职位。34 两人分处地球两侧,做的却是同一条「不做大语言模型、把预测直接放进表征空间」的路线。在这条路线上,出处就是卖点。
而在这一行,出处也不只是面子。这条线程里那位提问者的原话是:本来站在讲台上讲话的应该是我。13 它决定谁能招到人、谁能拿到钱、谁被请去讲话。
还有一个值得记下来的事实:到本篇发稿,这轮从 10 月 6 日烧到 10 月 8 日的争论,没有被任何一家主流科技媒体报道。 它在圈内传得很广——发起吐槽的那条帖 11.6 万次浏览,LeCun 的直升机帖 4.8 万——但它没有走出这个圈子。410
06 能核的与不能核的
这一轮里,能核的部分到 1991 年 4 月 30 日为止:那三项主张在文件里都能找到对应的机制,也都能在同行的引用链里找到另一个被记住的出处。
不能核的部分,是它之后所有关于「这笔账该记给谁」的问句。它没有受理窗口——这轮里没有,上一轮里也没有。
下一轮再有人贴出一份旧报告,说这东西是他先写的,读者只需要问一句:把它打开。
References
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
- 12Autogyro · Wikipedia(含首飞时间与其旋翼无动力、靠前进气流自转的定义)
en.wikipedia.org
- 13
- 14
- 15
- 16
- 17
- 18
- 19
- 20Bengio et al., Greedy Layer-Wise Training of Deep Networks(NIPS 2006)
proceedings.neurips.cc
- 21
- 22
- 23
- 24
- 25
- 26
- 27
- 28Stigler's law of eponymy · Wikipedia(载 Stigler 1980 原文引文与出处)
en.wikipedia.org
- 29
- 30
- 31
- 32
- 33
- 34
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.