名叫 Flash 的模型同一道题跑了 13 分钟、阿里版 Jev 三套题都输给大模型读概率、一个 322M 小模型接管六成告警流量
同一道鹈鹕题上,名叫 Flash 的新模型跑了 13 分 15 秒、90 tok/s,更早匿名上线的那个只要 2 分 34 秒、143 tok/s;同一套题库上,专用决策模型三套全输给普通大模型读出概率;一个 322M 的小模型零样本 38.3%,配上四代数据工程后接管六成告警流量:八组材料把每个名字旁边的实测值翻出来。

同一道前端题——用 SVG 画一只骑着自行车的鹈鹕,一次生成、不许中途修改——9 月 27 日交给刚上线的 MiniMax M3.1-Flash-Preview,一位测试者记下的读数是 13 分 15 秒、90 tok/s。几天前匿名上线、社区一度猜测出自 MiniMax 的 Space Bunny 跑同一道题,用时 2 分 34 秒、143 tok/s。这位测试者据此把结论改成了两者大概出自两家 1。
另一份材料换成了判断题。阿里 9 月 25 日放出的 decision-model-preview 是一款专做判断的模型,同一位作者把它和自己在两台 DGX Spark 上跑的 DeepSeek-V4-Flash-Vision-Exp 放在同一套题库上比。大模型那一侧什么都不加,只在请求里打开 logprobs,让它只吐选项词,然后把概率读出来。三套题里专用决策模型一套都没赢,英文原版差了 10.3 个百分点 2。
再往下是一个 322M 的模型接安全告警。它做三分类的零样本准确率是 38.3%,三分类瞎猜的期望是 33.3%。同一个模型经过四代数据工程之后站到 27B 大模型前面,把 61.7% 的告警直接处置掉,这一段的准确率是 95.0% 3。
这一期覆盖 2026 年 9 月 27 日至 9 月 28 日,来源为 X、Reddit、小红书与公众号,另含两处代码仓库与一份项目基准页。八组材料按「任务与运行条件 → 具体数字 → 分歧或反例 → 作者自陈的限制 → 原帖」逐条给出,供正在挑模型、自己部署和写验收规则的人核对。
八组材料总览
| 任务 | 测试对象与运行条件 | 关键数字 | 主要限制 |
|---|---|---|---|
| 一道前端题与一道纸箱算术题 | MiniMax M3.1-Flash-Preview,9 月 27 日上线 MiniMax Code、9 月 28 日公测,100 万 token 上下文、思考深度可调;同题另跑 Space Bunny、GPT-6 Astra Ultra、Claude Opus 5.5 max 14 | 鹈鹕题 13 分 15 秒/90 tok/s 对 Space Bunny 2 分 34 秒/143 tok/s;纸箱题加一句提示后 2.6 秒/218 token | 价格与跑分未公布;各测试者自己出题、互不通用;官方写的思考档位在一位测试者手里没生效 |
| 三套决策类题库 | 阿里 decision-model-preview 对两台 DGX Spark 上 DeepSeek-V4-Flash-Vision-Exp 读 logprobs;英文 JevBench 159 题、中文翻译 159 题、自编中文 120 题 2 | 英文 56.6% 对 66.9%、中文翻译 57.2% 对 65.0%、自编中文 85.8% 对 86.7%;评分类题 17% | 单机自测;读概率一侧未做校准;代理接入另有一组延迟与题量上限读数 |
| 50 道 MATH-500 随机题 | Qwen3.5-4B 的五个量化格式,一条 --logit-bias 把「wait」「maybe」「perhaps」这类标记词压低 2 5 | BF16 74%→84%、Q8_0 76%→80%、Q4_K_M 60%→66%、Q3_K_M 52%→66%、Q2_K 12%→24%;思考 token 少 11% 到 19.4% | 一个模型、一次测试;评论区用 220 万 token 真实日志复算,认为可省下的上限只有 1.6%–7% |
| 60 项工具调用任务 | Xyntetik-Kvist-14B:30B 父模型按宽度切一半再蒸馏,6000 步、9830 万 token、162 小时 67 | 57/60 对父模型 60/60、未训练对照 0;KLD 0.762;199/200 首轮格式正确、99/99 工具调用有效 | 作者自陈不适用通用场景;算术必须外挂计算器;12 次受控尝试里只有 2 次全量通过 |
| 177B MoE 单卡推理 | Inferred-Thoughts 引擎,Qwen3.8-Flash-Next NVFP4 权重 119GiB,RTX 5060 Ti 16GB 加 32GB 内存、Gen5 NVMe 89 | 解码 9.06 tok/s(最好 10.40)对同机 llama.cpp 的 4.9;预填 49.2;99GiB 留在 SSD | 只测两个模型、一个 GPU 家族;只做贪心解码;对话变深后掉到 6.88 |
| Strix Halo 上换一层引擎 | gufo 对 llama.cpp(b11069 与 6fcaa16f),Qwen3.8 Flash-Next Q4,AMD Strix Halo gfx1151、128GB 统一内存 10 | 预填最高 +792.4%、出字最高 +186.8%;加载 15.45 秒对 117.83 秒;内存 −0.8% | MTP 混合文本在 4K 深度反而 −5.7%;单用户出字 9 月 27 日测、预填 9 月 22–23 日测 |
| 告警三分类 | Laya 322M(mmBERT-base 基座)站在 Qwen3.8-27B(提示词调优)前面,2000 条冻结锚点,输入只给 HTTP 请求与响应两段 3 | 零样本 38.3%(随机假模型 34.1%);四代后整体 91.5%、攻击成功类 95.8%;级联分流 61.7%、该段 95.0%、漏入 3.6% | 单场景脱敏数据;全新指纹集上攻击成功类 4/24;延迟对比两侧硬件不同 |
| 100 个达人的标签与选人 | MiMo V2.6 Flash/GLM 5.3 Flash/GPT-6 Luna/DeepSeek V4.1 Flash,同一批抽帧与转写材料、同一套推荐规则、Sol high 盲评 11 | 成本 0.9/1.9/2.8/8.0 元;15 个名额选对 13/14/13/12;单人中位耗时 22 秒/55 秒 | 作者自述为粗略实测;只有 5 条模拟需求;这篇文章后段没有取到全文 |
同一道前端题,两个测试者给出相反的结论
MiniMax 9 月 27 日在 X 上宣布 M3.1-Flash-Preview 上线自家的 MiniMax Code,定位是「为日常开发打造」,卖点是从快速修 bug 到完整功能交付 4。9 月 28 日这款模型开启公测,官方口径是原生多模态、100 万 token 上下文,9 月 28 日至 10 月 7 日每天签到领双倍积分 12。
最先被量出来的是速度,而速度这一栏本身就分成了两半。同一位测试者拿同一道鹈鹕题同时跑了它和 Space Bunny,两边的推理档都开到 max,他把结果写成「Space Bunny 2 分 34 秒,M3.1 13 分 15 秒」,顺带一句冷知识:名字里带 Flash 的这一款并不快 1。另一位测试者把 M3.1 Flash 的 max 档和 GPT-6 Astra Ultra、Claude Opus 5.5 max 并排跑同一道鹈鹕题,他的判断是 M3.1 的逻辑没问题、只有翅膀没有手,画风整体更简单,用他的话说像精装房和毛坯房的区别 13。
小红书上的那条对比更细。作者拿同一道纸箱算术题问了四个模型——M3.1 Flash、上一代 M3、DeepSeek V4.1 Flash、GLM 5.3 Flash,四家都开到各自最高档,不加任何提示、上限 4000 token:M3 用 11.9 秒答完,DeepSeek 34.8 秒,GLM 39.4 秒,M3.1 49.6 秒,后三个的 token 全烧在思考里,答案根本没吐出来。他在提示词里加了一句「直接给结论和关键算式,不要展开长篇推理过程」之后,读数变成 M3.1 2.6 秒/218 token、M3 6.2 秒、DeepSeek 18.3 秒、GLM 71.4 秒,M3.1 是四个里唯一听话的 14。
同一篇笔记里的第二栏没那么好看。那道题是故意挖的坑:题目没给纸板强度,理论上算不出来。DeepSeek 和 GLM 直接说算不出来,还把缺的参数列全了;两款 MiniMax 都给出了具体数字,M3.1 说载重约自重的 15 到 20 倍、还能装 4.8kg,M3 说照样是自重的 3 到 5 倍、还能装 300 到 400 克,同一道题两个答案差了 15 倍,两家都拿不出出处。官方宣传的思考深度可调他也试了:thinking budget 和 reasoning effort 各设两档都被接受,思考量全在 500 上下,low 和 high 几乎没有差别 14。
另一个测试者的结论方向正好相反。他在 MiniMax Code 这个自家客户端上跑一批沿用已久的题目,记录下来的失败是一串:句子生成前两句对、后面全崩;鹈鹕骑车的方向反了;复合弓射箭左右手打架;浏览器 OS 弹窗关不掉;3D 赛车连路和车都没出现;Trello 看板的拖卡功能失效;一轮下来 800 积分烧光 15。
也有把它当工具用出结果的人。一位作者用它从零写了一个能联机的多人体素沙盒,约 6000 行代码(含 1700 行测试),服务端只有一个运行时依赖,协议手写 JSON,渲染用 three.js;83 个测试全绿。他最有感的一段是模型在跑自己写的测试时抓出了三个 bug:方块面整体平移了一格导致地形裂开、重力算了两遍导致跳不上台阶、重生广播漏发本人导致玩家卡死在死亡界面 16。
把这几组放在一起,能带走的是条件:价格与通用 API 都还没公布,每一条读数都出自单人单次、各自出的题,互相之间没有共同标尺。同一款模型在一个人手里 2.6 秒答完,在另一个人的自家客户端上跑同一批祖传题连翻六项。
Loading content card…
专用决策模型对上直接读概率的大模型
Jev 这一类决策模型的做法是收下状态和一组问题,一次前向直接给出选项概率,全程不生成文字。阿里 9 月 25 日跟着放出 decision-model-preview,公众号「史佚 Agent 开发团队」的作者在 9 月 27 日给出了它对上本地大模型的一份对照 2。
他的家底是两台 DGX Spark 组成的小集群,跑 DeepSeek-V4-Flash-Vision-Exp(320B 规模、双机并行),上下文 100 万,单流 40 到 60 tok/s。他要回答的问题是:既然决策模型本来就是普通大模型加一个读概率的出口,能不能让自己的大模型一鱼两吃?做法是不改模型、不加头、不训练,只改调用方式——把问题包装成选择题提示词,请求里带上 logprobs,让模型只输出选项词并返回它对各候选的原始概率分布,再做一次 softmax 归一化。他特别写了一句:模型直接输出 A/B/C 会让它把 A/B/C 当成对象单独计算,读出来的概率与选项本身的概率对不上 2。
数字落在三套题上,用的是 9 月 25 日评测阿里决策模型时同一批题目:英文 JevBench 原版 159 题,阿里 56.6%、大模型读概率 66.9%;中文翻译版 159 题,57.2% 对 65.0%;自编中文场景 120 题,85.8% 对 86.7%。英文简单题是 48 对 47,也就是 97.9%,接近全对。复杂题两侧一起掉:大模型读概率约 53%,阿里决策模型的英文复杂题是 37.8%;只读第一个词的概率时,英文评分类题目只有 17% 2。
作者自己列了三条短板:读出来的概率没有校准过,它说 90% 把握时真实正确率可能只有 80%,实测规律是置信度高才准(0.9 以上时准率 75%),这种概率做得了粗略门控、做不了精细风控;复杂评分题弱;决策请求与正常推理共用算力,高频调用会挤占本该干活的资源。他打算的下一步是照 Kev 的路子在现有模型上挂一个 rank-16 的 LoRA 加小指针头,专门把置信度校准到能反映真实正确率 2。
同一天,Reddit 上另一个人从接线那一头量了同一个 endpoint。他通过 AIHubMix 调用,服务端上报的 latency_ms 约 130 到 160 毫秒,加上网络与 TLS 之后端到端平均 644.9 毫秒,区间 473 到 882;他自己本地那个 router 平均约 439 毫秒。代理对问题数有硬上限,超过 16 个问题直接返回 400,错误信息是
questions: 19 exceeds the limit of 16;即便串行请求之间间隔 1 秒,也频繁触发限流。发帖人把试用结论写在编辑里,原话是这个 endpoint 目前还不值得切过去 17。Loading content card…
给「wait」和「maybe」加一层惩罚
r/LocalLLaMA 上一条帖子拿到 504 赞、97.5% 好评率与 109 条评论,做法只有一步:把一篇论文列出的 50 个「过度思考标记词」的概率统一压低 2。作者在 50 道随机 MATH-500 题上跑 Qwen3.5-4B 的五个量化格式,结果每一档都涨——BF16 74% 到 84%,Q8_0 76% 到 80%,Q4_K_M 60% 到 66%,Q3_K_M 52% 到 66%,Q2_K 12% 到 24%;思考 token 同步少掉 11% 到 19.4%,连不做量化的 BF16 也一样涨。作者自己只写了一句提醒:这是在一个模型上的一次测试 51819。
评论区里那条长回复是这份材料里信息量最大的部分。另一位用户拿自己 85 场真实 agent 会话、6851 个思考块、约 220 万 token 的 Qwen3.8-Flash-Next 思考日志做了一次观察分析,结论落在三个词上:值得惩罚的只有 Hmm、Wait、Actually 以及它们的大写与行首形式,能省下的思考最多 1.6% 到 7%,折成全部生成 token 只有 1% 到 4%。两个裁判模型意见一致的比例是 61%,都判定为浪费的只占 12%;被判为「有用」的犹豫占 63%,其中 29% 真的抓到了 bug 或错误假设;模型给自己打分时只认 8% 是浪费,35B 裁判认 37%。他还点了一个实现坑:vLLM 在投机解码打开时会直接拒绝带
logit_bias 的请求(issue #42744)5。这份回帖把自己的边界写得很清楚:整个过程是读日志,没有把惩罚打开跑过一次 A/B,因此准确率会怎么变仍然未知;裁判也是模型,彼此只部分一致;样本是一个模型、一种量化、一类工作负载,与论文里数学题的口径差别很大 5。
Loading content card…
把 30B 沿宽度切一半,再蒸馏补回来
一位作者把自己喜欢的 30B 模型 Muse-Glimmer 按宽度切了一半:hidden 从 6656 降到 5760,FFN 从 19968 降到 10240,heads 从 32 降到 24,52 层全部保留。切完的模型有 14.44B 参数,BF16 28.9GB、Q8_0 15.4GB、Q5_0 混合 10.3GB。他再花 6000 步、9830 万 token、162 小时把能力蒸回来,之后又用 1440 步喂 agent 轨迹。对父模型的一致度写成 KLD 0.762,margin-qualified top-1 在 45,056 个留出位置上是 84.0% 67。
真正的结果栏是一组 60 项的闭环工具任务——联系人、天气、航班、汇率、日期、单位、股票——按重新执行调用后对答案计分:这个 14B 学生模型做对 57 项,父模型做对 60 项,未训练的对照做对 0 项。格式与调用上,200 个首轮里 199 个格式正确,99 次工具调用全部有效。发布过程本身也写进帖子里:12 次受控尝试,2 次全量通过,第 12 次才发布 6。
弱项那一栏写着:计算类任务 15 次里有 12 次超过 160,作者的建议是给它挂一个计算器工具,模型卡上直接写明了不挂会算错「2,340 的 17%」;160 次运行里有 7 次跑进推理循环。模型页上还挂着完整的训练记录,包含预注册、修改记录和缺陷记录 620。
作者的编辑补在最前面的是限制:这款模型不适合通用替代,9830 万 token 的蒸馏量跟一次正经蒸馏要的万亿级差了两个数量级,他的目的只是把工具调用调对;花费约 160 小时以上的 GPU 时间。有人在评论区追问他 100M token 够不够训练,他的回答是通用用途下不够。他也补了一句量化后的现实:IQ4_NL 混合降到 7.6GB 后工具任务仍是 57/60,但整张 8GB 卡装不下——3070 上只能装 52 层里的 50 层,速度约 5 tok/s 6。
Loading content card…
99GiB 留在 SSD 上,20GiB 进内存
一个叫 Inferred-Thoughts 的引擎今天在 r/LocalLLaMA 上发布,写法是 Rust 加 CUDA,专治装不进显存与内存的 MoE 模型:大部分权重留在 NVMe 上,专家被路由器点中时才读进来。引擎把内存层级当成一等调度问题,做前瞻预取、GCLOCK 淘汰和分层预算 89。
作者把 119GiB 的去向列成了一张表:dense 权重(注意力、共享专家、LM head)4.4GiB 在显存;token embedding 表 0.6GiB 在内存、每 token 读一行;最热的 routed experts 8.8GiB 在显存;次热的 6.0GiB 钉在内存;其余 routed experts 48.5GiB 留在 SSD 按路由结果流式读取;n-gram 表 50.7GiB 也留在 SSD,每 token 读 16 行。两栏加起来是 20GiB 在内存层级里、99GiB 在盘上,跑它的机器是一张 16GB 的 RTX 5060 Ti 加 32GB DDR5 9。
速度那一栏是这组材料的重点:176.9B 的解码是 9.06 tok/s,最好的一轮 10.40;预填 49.2 tok/s(5,548 token 的提示词)。同一台机器、原生 Windows 上,llama.cpp 解同一个 176.9B 平均 4.9 tok/s。作者也给出了开销的另一面:解码随对话变深往下掉,0.2k 深度 10.40、约 6k 深度 8.35(一轮 1,111 token 的回复)、约 29k 深度 6.88(Cline 跑了 33 轮、6 次工具调用)9。
第二个模型小得多也快得多:Qwen3.6-35B-A3B 的 NVFP4 权重 19.1GiB,预填 591.2、解码 47.3 tok/s,随对话变深从约 4k 的 47.5 一路降到约 100k 的 33.8。权重格式上,这条路用的是 NVFP4,每 16 个权重共用一个 FP8 缩放,合到 4.5 bit,好处是 Blackwell 张量核能直接吃 FP4×FP4,不用先拆到 8 位或 16 位 921。
作者在「局限与下一步」里写:这套东西只在两个模型、一个 GPU 家族(RTX 50 系与 RTX PRO Blackwell,内核为 sm_120a)、Windows 11 与 WSL2 上测过,原生 Linux 没测;解码只支持贪心;下一步才是更大的模型、更老的显卡和原生 Linux。仓库 7 颗星,作者自己写明这是第一版 9。
Loading content card…
同一台 Strix Halo,换一层引擎
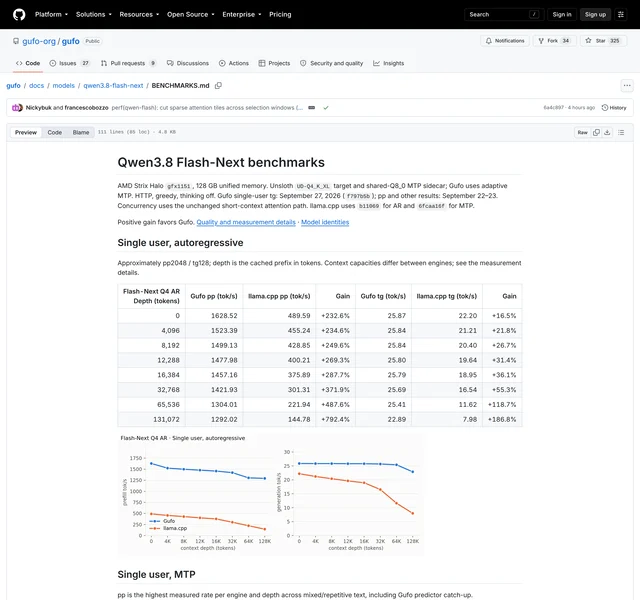
gufo 项目在自己的仓库里放了一页基准,测的是同一台 AMD Strix Halo(gfx1151、128GB 统一内存)上 Qwen3.8 Flash-Next Q4 的两个引擎:目标权重是 Unsloth 的 UD-Q4_K_XL,MTP 配共享 Q8_0 旁路,走 HTTP、贪心解码、思考关闭;对照组是 llama.cpp 的 b11069(自回归)与 6fcaa16f(MTP)。页首写明单用户出字测于 9 月 27 日,预填与其余结果是 9 月 22 至 23 日的 10。
预填这一栏的差距随上下文长度放大:0 深度时 gufo 1628.52 tok/s 对 llama.cpp 489.59(+232.6%),到 131,072 深度是 1292.02 对 144.78(+792.4%)。出字的绝对值变化小得多,但相对差距同样放大:0 深度 25.87 对 22.20(+16.5%),131,072 深度 22.89 对 7.98(+186.8%)。加载时间是这条对照里最悬殊的一栏——冷缓存到 HTTP 就绪,gufo 15.45 秒,llama.cpp 117.83 秒 10。
另一栏没占到便宜。峰值内存两行分别是 85.55 对 84.84 GiB(−0.8%)和 86.27 对 85.31 GiB(−1.1%),也就是说换了引擎之后显存与内存占用基本没变。MTP 那一页也藏着一个反向行:混合文本的出字在 4,096 深度是 32.50 对 34.48,即 −5.7%,是整页唯一为负的一格;同一页的重复文本出字在 8,192 深度是 50.26 对 44.31(+13.4%)。换句话说,开了 MTP 之后能拿到多少,跟喂进去的文本类型绑在一起 10。
多人并发那一页方向一致:8 路自回归合计 108.67 对 68.79 tok/s(+58.0%),8 路 MTP 的重复文本合计 157.22 对 58.13(+170.5%)10。
同一天另有两个现场读数。r/LocalLLaMA 上一位用户报出他在同一类机器上的实测:6204 个 chunk 用了 119.0 秒,encode 1239 tok/s,decode 57 tok/s(开着 MTP),并称这个预填速度是他用过最快的 Strix Halo 专用分支的两倍。基准页里最接近 57 的一栏是 MTP 重复文本在 0 深度的 59.30(同栏 llama.cpp 48.12),纯自回归档在 0 深度是 25.87。另一位在 X 上报的是 260k 上下文用到 40% 时预填 1191.35 tok/s、出字 36.13 tok/s 2223。
322M 站在 27B 前面
公众号「蝈蝈简笔」这篇记录的是某安全大数据平台的告警研判(脱敏测试环境):设备吐出一条告警,模型要把它分成攻击成功、攻击失败、误报三类。大模型先上了岗,判得准,但单条约 31 秒、还占着 NPU。作者的思路是在前面放一个小模型,便宜的活它干,拿不准的转给大模型,选中的是 322M 的 Laya(convaiinnovations 出品,基座是 mmBERT-base)3。
评测口径先定死:2000 条冻结锚点,三类各三分之一(667/667/666),固定随机种子,此后每一代微调都不动这批题;输入只给 HTTP 请求与响应两段。作者改掉的第一版把告警名称也喂了进去,名称里写着「SQL 注入」,答案等于印在题干上。零样本跑下来是 38.3%:攻击成功 38.5%、攻击失败 58.3%、误报只有 18.0%;93.8% 的样本最高置信度不到 0.5,也就是说它知道自己不行,置信度门控在零样本状态下直接失效 3。
为了证明这个 38.3% 是干净的,作者往同一条评测管线里塞了一个「协议壳加伪随机数」的假模型 Jev-Quantum,它长得像模型、内部没有可训练权重。假模型拿到 34.1%,逐类落在 32% 到 36%,稳稳待在随机期望 33.3% 的波动带里。这条随机标尺一次给了两个结论:管线没有泄漏,真模型确实在它之上 3。
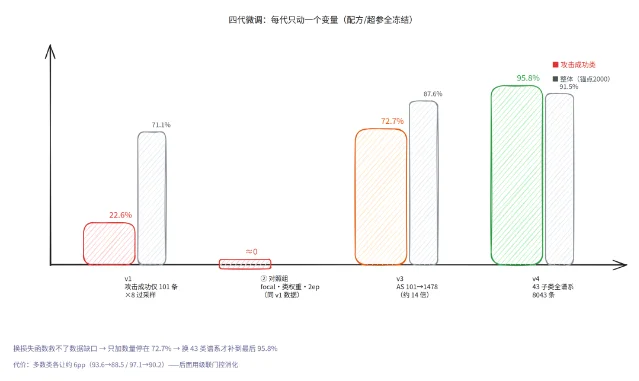
第一代微调把整体拉到 71.1%,比零样本高了 33 个点,但分类别看是塌了一类:攻击失败 93.6%、误报 97.1%、攻击成功 22.6%,比瞎猜这个类的期望 33.3% 还低;换成 682 条全新指纹的告警,攻击成功是 0/24。原因是数据——攻击成功在真实流量里本来就是小众,全池独立样本只有约 212 条,能进训练的 101 条,作者用 8 份过采样把它凑成 808 条。置信度门控方向有效但救不了这一类:校准后高置信段(conf≥0.8、覆盖 29.7% 的样本)准确率 89.1%,可模型对攻击成功的错判同样是高置信的,错得理直气壮 3。
作者下一个尝试是改算法,focal loss、类权重、把 epoch 砍到 2,对照组的每一项都跟 v1 冻结一致,只换这一个变量,双卡并行跑一夜。结果攻击成功 0/24 纹丝不动。这一步把「算法不行」这个假设洗掉了,剩下的解释只有数据。后面的路他自己总结成一句话:损失函数只能调错判罚多重,调不出模型没见过的新花样 3。
改法的分水岭是第三代的「凑花样」和第四代的「铺谱系」。v3 把攻击成功的同源训练数据从 101 条扩到 1478 条,涨到 72.7%,整体 87.6%,但真攻击漏进自动关单段的比例还有 24.6%。v4 换问法,按攻击子类铺满 43 个谱系、凑到 8043 条,攻击成功从 22.6% 一路走到 95.8%,整体 91.5%。代价写得也清楚:多数类各让了约 6 个点,攻击失败从 93.6% 降到 88.5%、误报从 97.1% 降到 90.2% 3。
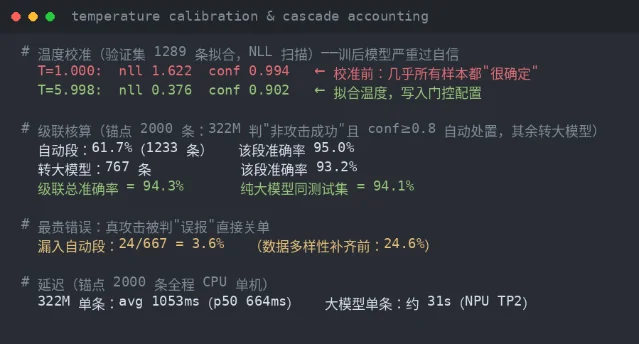
上岗前还有一步是温度校准,作者把它写成必做项:微调完的模型在验证集上原始置信度普遍到 0.994,几乎每个预测都说自己十分确定,不校准的话门控就是摆设;校准用的验证集 1289 条从训练数据里独立划出。做完校准才上级联:小模型判出「非攻击成功」且校准置信度≥0.8 的自动处置,其余全部转大模型。为什么保守的方向交给小模型、把攻击成功永远留给大模型,作者用错误代价解释——把误报判成攻击只浪费一次人工复核,把攻击判成误报就直接关单,真入侵从眼皮底下过去 3。
最终的成绩单是三个数一起看:分流 61.7%(1233/2000)、该段准确率 95.0%、真攻击漏入 3.6%,级联总准确率 94.3%。对手那 94.1% 有来历:同一款 Qwen3.8-27B 在同一测试集上用普通提示词只有 73.0%,94.1% 是它调过提示词之后的成绩。作者把对比的公平性也交代了:0.2 个百分点的差距是 4 条样本的抖动,当打平看 3。
剩下的风险由作者自己点出来:在 682 条全新指纹的泛化集上,v4 整体 92.5%,攻击成功只有 4/24,光谱系没铺到的全新攻击手法仍是短板;还有一条评测里的暗礁被单独写了一节——安全告警里同一攻击手法的请求长得几乎一样,按指纹聚簇后同簇近重复有 447 到 571 条一组,切分必须整簇只进一边,否则同一个指纹的双胞胎一条进训练一条留测试,分数看着在泛化、其实在背题 3。
一百个达人的标签,四个模型的价格
公众号「Ocean-AI Builder 版」的作者做达人营销,9 月 28 日那篇记的是同一批活交给四个便宜模型的结果。任务设定是 100 个达人、每人 3 条视频,统一抽帧、转写语音;四个模型看同样的材料,推理开到各自最高档,打完标签后用同一套规则给 5 条模拟品牌需求各推荐最多 3 人,再隐藏模型身份,让 Sol high 对照视频证据盲评 11。
成本栏拉得很开:MiMo V2.6 Flash 0.9 元、GLM 5.3 Flash 1.9 元、GPT-6 Luna 2.8 元、DeepSeek V4.1 Flash 8.0 元。选人那一栏的方向不同——15 个名额里 GLM 选对 14 个,MiMo 和 Luna 各 13 个,DeepSeek 12 个,还空了 1 个名额。速度栏又是另一个顺序:MiMo 是四个里最快的,单个达人耗时中位数 22 秒,GLM 是 55 秒。格式上最省心的是 Luna 11。
成本栏的顺序是 MiMo、GLM、Luna、DeepSeek,选人栏的顺序是 GLM、MiMo 与 Luna 并列、DeepSeek。作者还记了一个巧合:GLM 多对的那一个有点运气——一份标签格式写坏了,刚好把一个不合适的人挡在名单外 11。
这一组缺一栏:这篇文章的后半段(含作者自述的测试限制)没有取到全文,上面这些数字来自它已公开的正文段落,盲评只有 5 条模拟需求、评的名字也不多,名次接近的几款放在一起比意义有限。
今天能带走的三句话
第一句,把数字和它成立的条件一起念出来。M3.1 Flash 的 2.6 秒对应的是提示词里写明了「直接给结论和关键算式」;不加这一句时,同一个模型 49.6 秒还没把答案吐出来。同一台 Strix Halo 上换一层引擎,预填在浅上下文领先 3.3 倍、到 131K 深度领先 8.9 倍;同一个引擎在 MTP 混合文本的 4K 深度落后 5.7%。
第二句,模型自己写出来的档位与置信度都要验一遍。M3.1 Flash 的思考深度两档实测思考量都在 500 上下,low 与 high 没差别;322M 告警模型微调完的原始置信度是 0.994,不校准就拿去做门控等于没做。
第三句,把「错在哪一类」和「漏了多少」单独记一栏。告警那套体系里最贵的错误是真攻击被判成误报直接关单,作者从第一代起就单盯这个数:v3 时代 24.6%,v4 降到 3.6%,而整体准确率只从 87.6% 动到 91.5%。
留一个能自己动手的核对项:拿手上正在比的两三个模型,用同一批材料跑一遍,把结果拆成两栏记——一栏是耗时、成本、体积和吞吐,另一栏是对不对、错在哪一类、漏了多少;然后只改一个变量再跑一遍,一条
logit-bias、一层推理引擎、一句提示词、一次温度校准都可以,看哪一栏动了。References
- 1X:雪瑜的鹈鹕对照测试
x.com
- 2公众号 史佚Agent开发团队:本地部署Jev决策类模型有必要吗
mp.weixin.qq.com
- 3公众号 蝈蝈简笔:322M 的小模型能干活吗
mp.weixin.qq.com
- 4X:MiniMax 官方发布帖\
x.com
- 5Reddit:给过度思考词加惩罚\
reddit.com
- 6Reddit:把 30B 切一半再蒸馏\
reddit.com
- 7Hugging Face:Xyntetik-Kvist-14B\
huggingface.co
- 8Reddit:177B 走 SSD 流式\
reddit.com
- 9GitHub:Inferred-Thoughts\
github.com
- 10gufo:Qwen3.8 Flash-Next 基准页\
github.com
- 11公众号 Ocean-AI Builder版:给100个达人打标签只要九毛\
mp.weixin.qq.com
- 12公众号 第一财经:MiniMax新模型上线
mp.weixin.qq.com
- 13X:Mrooo03 的鹈鹕三方对比
x.com
- 14小红书 Bin:MiniMax M3.1 Flash 到底快在哪
xiaohongshu.com
- 15小红书 AI产品狙击手:Minimax M3.1 Flash测评
xiaohongshu.com
- 16小红书 行走大师:MiniMax M3.1-Flash-Preview 体验
xiaohongshu.com
- 17Reddit:Qwen 也出了 Jev 竞品
reddit.com
- 18arXiv:2606.00206
arxiv.org
- 19MATH-500 数据集
huggingface.co
- 20Hugging Face:Xyntetik-Kvist-14B 训练记录
huggingface.co
- 21Hugging Face:CompiledThoughts Qwen3.8-Flash-Next-NVFP4
huggingface.co
- 22Reddit:在 Strix Halo 上用这个软件跑 Flash-Next
reddit.com
- 23
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.