单次生成 3.5% 可用:Google 用十轮自动批改把生成式课堂模拟推到 69.3%
解读 Google Research 2026 年 9 月 17 日发布的生成式课堂模拟研究:第一次生成的界面只有 3.5% 能通过全部自动检查,十轮回炉后升到 69.3%,教师评测的接受率是 86%,而学生的学习效果还没有读数。

Google Research 在 2026 年 9 月 17 日公开了一套让教师自己生成课堂模拟的系统。教师在请求里写明学科、年级和一个具体题目,比如「高中物理:复杂直流电路」,Gemini 就会写出一整个能上手操作的交互式界面:学生拖滑块、按按钮,看曲线和仪表跟着变,一关一关往下闯。这套做法叫生成式界面(generative UI),普通做法是把内容填进预先做好的模板,这里连界面一起由模型现场写出来1。随博客一起放出的还有配套技术报告《Harnessing Generative UI for Education: Tailored Learning Interactives》,以及一个 30 多个模块的样例库,全部由 AI 生成、经教师审核,覆盖初中与高中的物理、化学、生物、数学等 STEM 科目1。
报告里有两个数字划定了这件事现在的位置。在模拟构想与逐级关卡都已经过验证的前提下,模型第一次生成出来的界面能通过全部自动检查的比例是 3.5%;让它自己回炉批改到第十轮,这个比例升到 69.3%2。这两个数字衡量的是界面生成这一步,报告没有给端到端的首次生成成功率。
真正的门槛是判断生成出来的界面能不能用。一道关卡能不能被解出来、提示有没有把答案直接送出去、仪表读数和学生按下的按钮对不对得上,这些都能写成程序跑一遍;一段解释文字写得顺不顺,只能靠人读。这套系统的工作量因此大半落在把「这算不算好」翻译成一条条可以执行的检查,落在模型之外。
从教师请求到关卡界面的四段
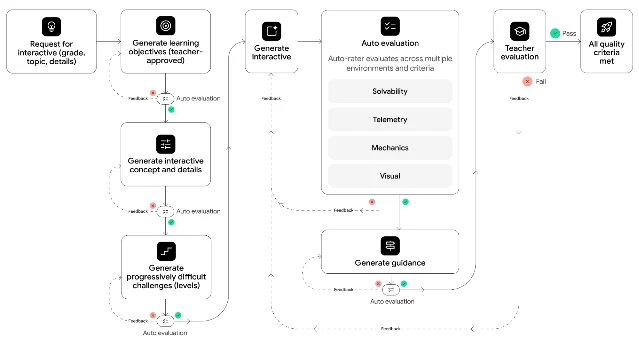
第一段把教师的请求变成一组具体的学习目标。目标由模型起草,教师可以修改,批准之后才作为后续所有生成的依据。报告说,绝大多数目标都是原样通过的2。
第二段生成「模拟构想」。报告给的例子是一道高中物理的复杂直流电路题:构想被拆成从发射端到接收端的一条信号通路,依次穿过 RC 脉冲整形、LC 谐振、p-n 结放大和传输互连四级,学生的任务是把每一级都调到能支持目标频率(例如 10 GHz)而不让波形失真。构想里逐项写明了实体、实体之间的关系、要画的实时曲线、界面上的视觉表现,以及旋钮的取值范围,比如目标频率滑块的量程是 100 MHz 到 50 GHz2。
第三段把关卡拆开。系统为每个交互生成 5 级递进的关卡,每一级都要满足四个性质:具体(在本模拟里能被解出来)、清楚(难解但好懂)、递进(比上一级更复杂或者引入新概念)、脚手架(不能比上一级难太多)。报告写明,想让模型一次就把这 5 级同时写对,几乎不可能,因为递进和脚手架是逐级累积的关系;于是每一级都在前几级的基础上单独生成,生成完立刻对照这几条性质批判,不通过就重做2。
第四段才轮到界面本身,也是最容易出问题的一段。报告写明界面生成比文本生成更容易失准:容易堆出分散注意力的视觉元素,也容易做出目标根本达不到的关卡。为此系统对生成的 HTML/JavaScript 代码和它在 Chrome 里的实际渲染结果同时开四类批判——视觉、可解性、遥测、机械,逐类挑错并回炉。可解性这一项由智能体执行:它会真的开一个 Chrome 实例,像用户一样操作这个模拟,还会做对抗性试探,比如把旋钮拉到极端值2。
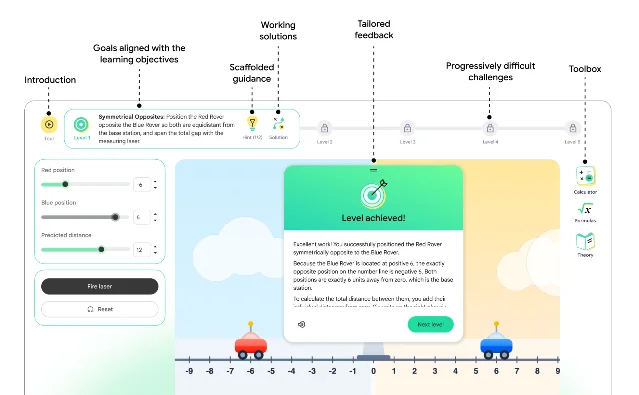
四类批判都通过之后,最后生成引导内容:开场导览、每一级的提示与解答、学生答对或答错之后的分析与反馈。四支柱的教学原则就在这四段里各自落到一个具体的界面决定上:
| 教学原则 | 落到界面上的决定 |
|---|---|
| 与课程和教师的目标对齐 | 学习目标由模型起草、教师修改并批准,之后所有生成都以它为准2 |
| 探究式学习与动机 | 把复杂概念拆成目标明确的逐级关卡,难度递增,学生靠动手试出结论2 |
| 引导与脚手架 | 开场导览、装满公式与理论的工具箱、多级提示、指向思路的实时反馈2 |
| 形成性反馈 | 开场唤醒相关知识,做完之后有复盘和完整解答2 |
3.5% 是怎么走到 69.3% 的
把界面生成这一步单独拎出来看,报告给了一条明确的曲线。首次生成就通过全部四类批判的只有 3.5%,改进到中途是 28.9%,到第十轮是 69.3%2。报告同时提醒,四个批判方向上的改进并不同步,某一个方向的修补会牵动另一个方向,界面里各部件的关系比较微妙,改进曲线因此不是一路向上的2。
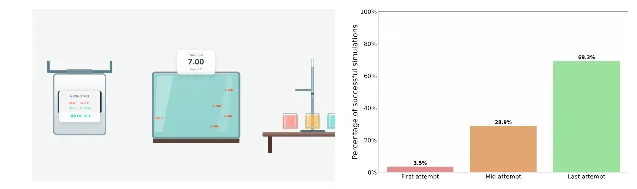
剩下那 30.7% 差在哪里,报告没有逐条交代。这类缺陷人一眼能看出,难的是让程序也看出来,而报告的做法就是在 Chrome 里量它:页面溢出多少、遥测和模拟物件有没有重叠、这一关在当前参数下能不能被解开。
教师拿到手之后,两组评测各自测了什么
生成质量之外,报告用两组教师评测回答「这东西人能不能用」。
第一组是深访。12 位美国 STEM 教师,每人提 3 个自己学生用得上的模拟请求,一共 36 个;每个请求生成 5 个候选,由内部评分者挑一个最好的交给教师。36 个请求里只有 3 个的生成结果质量差到不能拿给教师看;教师给出的可用性评分全部在 7 分以上(满分 10),平均超过 8.1。报告补了一句,这批评分是在系统的若干组件尚未实现的情况下给出的2。
教师反馈里被反复提到的是按需定制。一位高中科学教师说:
如果我上课的时候能把这个主题直接打进去,然后一个模拟就出来了,那太棒了……我以前从来没办法给不同的学生做区分,因为现成的模拟就是这样,你拿到什么就是什么。
另一位初中科学教师提到脚手架的作用:这套东西把她平时绕着一圈、一个一个讲的步骤提前做掉了,学生不至于干等着老师走过来2。
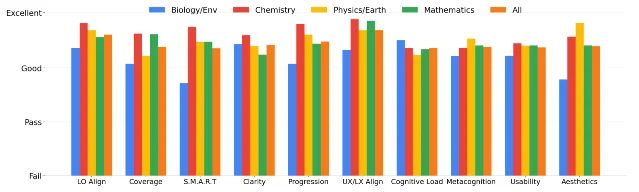
第二组评测把规模放大,也把评价者换成了独立的人。教学专家先挑出 40 个覆盖不同题材和年龄段的请求,每个请求做 5 次生成尝试,通过了全部批判的成品交给两名分别教对应学科的评分者:先判断能不能接受,接受了再按十项细则打分,档位是 fail、pass、good、excellent 四档,换算成 0 到 3 分取平均。40 个请求的总体接受率是 86%,被接受的那些大多落在 good 与 excellent 之间2。
学科差异给出的天花板
分学科看,差距是清楚的。物理和化学平均最接近 excellent;生物明显偏弱,主要在美感与 UX 两项上2。报告给的解释落在题材本身:生物里不少主题(它举的例子是细胞周期)要求学生记住一连串细节,生成出来的东西更像按顺序翻的课本,可以上手操作的部分就少了;物理和化学的题目里通常有方程和变量可以拨动,模型也就有东西可以做成关卡2。
这条解释把这套方法的边界说清楚了:它适合有可操作状态空间、对错能被算出来的题材。同一批研究者此前发表过一篇更早的通用生成式界面论文(arXiv:2604.09577),结论是只要提示得当、工具齐备,现代模型能对几乎任何提示稳定产出高质量的自定义界面,效果与人类专家的作品在至少半数情况下可比3;Yossi Matias 同时出现在两篇材料的作者名单里23。
两篇材料的差别落在检验标准上。通用生成式界面的好坏由人的偏好判定,教学模拟的好坏可以被程序判定:这一关能不能解出来、提示有没有泄题、遥测面板上的读数和学生按下的按钮是不是一回事。产物一旦可以被检验,十轮回炉就有地方落地,通过率从 3.5% 走到 69.3%;产物只能靠人看的时候,回炉这一步就只由人来做。
这套评测还没有测到什么
两组评测测的都是教师对产物的判断,不是学生学得怎么样。报告自己在讨论部分把最缺的一项写了出来:最需要的是真实学校、真实教师场景下的评测,以及学生的学习效果;Google for Education 的 pilot 计划就是为这个开的24。使用 Google Workspace for Education 的学校可以报名参加 pilot,教师提出的模拟请求生成后先送回给这位教师审核,通过了才会进入公开库1。
还有几处口径要一起记下。40 个请求的评分工作由两名评分者承担,他们分别教对应的学科;每个请求先出 5 个候选,评分对象是挑过一轮的成品;12 位教师的请求是他们自己选的。报告没有给出生成一个交互的成本和耗时,只说迭代会拉长时间,而目标与关卡这两段相对于界面生成和批判可以忽略2。
报告在引言里就直接面对了生成式 AI 进入学习场景的争议,引了两项负面证据——用 AI 助手写论文会累积「认知债」,以及教育里「增强还是侵蚀」的悖论——并把应对写成设计决定:把开放式沙盒留在门外,把复杂概念拆成逐级关卡,再配上脚手架。这套做法是否真的避开了那些风险,要等 pilot 的学习效果数据出来才能回答2。
接下来值得盯的是三个读数。pilot 的实地研究与学习增益;标准对齐,报告提到教师希望模拟请求能对上课程标准,评分细则里也把 NGSS、共同核心、AP 和英国国家课程列为对照项;以及公开库的扩展速度和审核机制12。
眼下可以自己动手的有两处:公开的样例库,以及面向学校的 pilot 报名。报告自己把真实课堂里的学习效果列为下一步,这个读数要等 pilot 跑起来。
References
- 1
- 2Harnessing Generative UI for Education: Tailored Learning Interactives(技术报告)
services.google.com
- 3
- 4Google for Education Pilot Program
edu.google.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.