Particle-1 发布:token 少三成到五成,缓存读却贵五倍
Particle 用 DeepSeek V4.1 Flash 后训练出 Particle-1:四项编码基准上输出 token 少 28.4%–52.2%,官方按两家同一价目算出每任务便宜 34.4%–51.6%;但按各自今天的价目,它的缓存读每百万 token 收 0.03 美元、比 DeepSeek 贵五倍,省不省钱取决于你的缓存命中率。

北京时间 10 月 29 日 01:36,Suhail Doshi 在 X 上发出 Particle 的第一条公告。1
particle.ai 几乎同时上线,公司只推出一款自己的模型:Particle-1。
Particle 在旧金山,自称「Advanced Inference Group」,把使命写成「让智能像电一样便宜」。2
投资方是 Y Combinator、8VC 与 Caffeinated Capital,天使名单里有 Patrick Collison、Adam D'Angelo、Aaron Levie。2
第一款模型不是从零训的。Particle-1 在 DeepSeek V4.1 Flash 上做后训练,只加了一个 rank-64 的 LoRA(低秩适配器,只训练模型里很小一部分参数)。3
它卖的东西一句话:同样的分数,更少的 token。
省下的是 token 还是账单,是这期要拆的事。
先说结论
- 是什么:DeepSeek V4.1 Flash 的后训练版本,用强化学习压短推理与工具调用;首个版本只做软件工程,权重不发布,只能走 Particle API。3
- 官方宣称:四项编码基准上输出 token 少 28.4%–52.2%,每任务成本低 34.4%–51.6%,pass@1(一次尝试就通过的比例)落在基座的置信区间内。3
- 已经能核对的:API 今天就能调,OpenAI 兼容;上下文 1,048,576,输出上限 131,072;预付费,推理流量零留存。45
- 要小心的:那组「便宜 34%–51%」是把两家按 DeepSeek 的价目算的,不是 Particle 的账单。3 它自己的缓存读每百万 token 收 0.03 美元(缓存读指命中输入前缀缓存的那部分输入,按更低价计费),是 DeepSeek 的五倍。6
- 多少钱:峰时输入 0.25、缓存输入 0.03、输出 1.00 美元每百万 token;谷时全部半价,Flex 档再半价。6
- 现在该做什么:拿自己的 agent 轨迹跑一次 A/B,先量出缓存命中率,再谈省不省钱。
快速核对
| 项目 | 内容 | 来源 |
|---|---|---|
| 发布时刻 | 2026-10-28 17:36 UTC,即北京时间 10 月 29 日 01:36 | 发布帖 |
| 厂商 | Particle,旧金山;创始人 Suhail Doshi(Mixpanel 创始人) | About · 报道 |
| 模型关系 | 在 DeepSeek V4.1 Flash 上后训练;首个版本只针对软件工程 | 官方博客 |
| 训练 | rank-64 LoRA 覆盖所有层的专家,可训练参数约为模型总量的 1.25%;两段 Cascade RL;GSPO;Miles + SGLang + Megatron | 官方博客 |
| 规格 | 文本与图像输入、文本输出;上下文 1,048,576(输入输出合计);输出上限 131,072 | 模型目录 |
| 官方评测 | 四项基准跑统一 harness:Terminus 2 agent、512K token 上限、temperature 1、最高推理档、每题 16 次运行 | 官方博客 |
| 第三方 | Artificial Analysis 与 Vals 都还没有条目;OpenRouter 上只有它自己一个供应商 | AA 榜单 · Vals · OpenRouter |
| 可用范围 | 今天即可通过 Particle API 调用;权重不开放 | 官方博客 |
| 价格 | 峰时 0.25 / 0.03 / 1.00;谷时半价;Flex 再半价;联网搜索 2.50 美元每千次 | Usage & billing |
| 现在该做什么 | 用自己的轨迹跑 A/B,记输出 token、缓存命中率、每任务实付三项 | — |
45% 这个数,背后有三个口径
标题写「平均少用约 45% 的 token」。同一屏上还有三组数。3
每任务成本 0.2211 对 0.3368 美元;平均 token 59,580 对 83,246;通过率 72.57% 对 71.15%。3
把 83,246 和 59,580 放在一起,少 28.4%,正好是官方区间 28.4%–52.2% 的下限。3
成本同理:0.3368 与 0.2211 相除是 34.4%,也是区间下限。3
45% 是哪一个,官方没写。按它自己给的四个基准合并算,落在 28.4%。
第二个口径在价格。成本图的脚注写明:两个模型都按每百万 token 输入 0.30、缓存输入 0.006、输出 1.20 美元计,缓存命中率固定 95%。3
这三个数与 DeepSeek 价目页上的峰值价逐项一致。7
也就是说,那张成本图把两家放在同一张价目上,量的是 token 差异,不是你在 Particle 付的钱。它自己的价目是 0.25 / 0.03 / 1.00。6
第三个口径是 95% 的缓存命中。它意味着输入侧几乎全按缓存价计费,而两家的缓存价差得最远。
按它自己的价目,账要重算一遍
官方给了每任务成本和平均输出 token,再配上官方单价,可以反推每任务的输入 token。3
反推的结果:Particle-1 约 723 万,基座约 1,145 万。这是按官方口径算的,官方没有直接给。
把它放进四张账单,结论会分叉:
| 怎么算 | Particle-1 | DeepSeek V4.1 Flash | 差距 |
|---|---|---|---|
| 官方口径:两家同用 DeepSeek 峰值价,95% 缓存命中 | 0.2211 | 0.3368 | 低 34.4% |
| 同在 Particle 价目:0.25 / 0.03 / 1.00 | 0.356 | 0.553 | 低 35.6% |
| 各按自家峰值价 | 0.356 | 0.337 | 高 5.7% |
| 各按自家谷时最低价(Particle 谷时 + Flex) | 0.089 | 0.168 | 低 47.2% |
第二行不是假设:Particle 也把 DeepSeek V4.1 Flash 按同一张价目转卖,今天就能两边下单对比。6
第三行是这期最该记住的一处。在 95% 缓存命中下,Particle-1 按自己的价目跑完同一套题要 0.356 美元。
基座在 DeepSeek 官方只要 0.337 美元——贵 5.7%。
原因在单价上:缓存读 0.03 对 0.006,差五倍。而这类 agent 任务,七到八成的钱花在输入侧。
结论也不是死的。命中率从 0 拉到 100%,两条线在 93.9% 交叉:低于它 Particle-1 更便宜,高于它更贵。
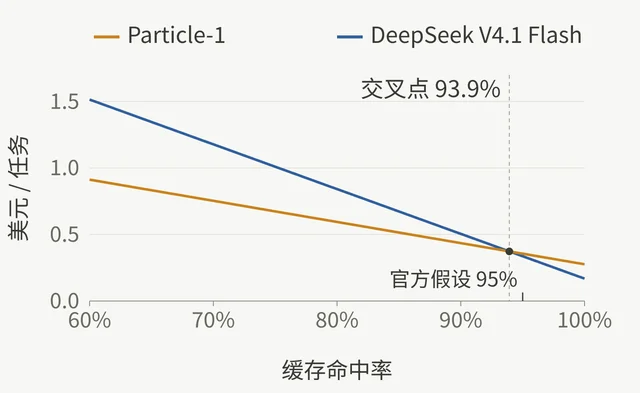
本刊按官方数字绘制,非官方图。每条线的输入 token 由官方「每任务成本 + 平均输出 token」反推(Particle-1 约 723 万,基座约 1,145 万),输出按各自单价计;缓存按 Particle 官方假设固定命中比例。官方假设的 95% 落在交叉点右侧,正是两条线几乎重合的位置。
谷时是另一回事。Particle 的谷时是纽约时间 20:30 到次日 04:00,所有 token 半价;Flex 档再打五折。6
叠起来是输入 0.0625、输出 0.25,也就是标价的四分之一。
DeepSeek 的谷时也是半价,但两家窗口不重合:DeepSeek 的峰值是 UTC 01:00–04:00 与 06:00–10:00 的工作日。7
同一时刻可能一家全价、一家半价。所以「省不省钱」不看模型,看你的缓存命中率和运行时段。
省 token 是训出来的,不是蒸馏
Particle 把后训练分成两段(Cascade RL,一段训一类任务,训完进入下一段):第一段只训编码,第二段把数据工程并进来。3
官方曲线里,第一段的平均降幅推到接近 40%;切到第二段时断崖落到 25% 左右,再爬回 44%。3
断点是训练集切换造成的,不是能力倒退。3
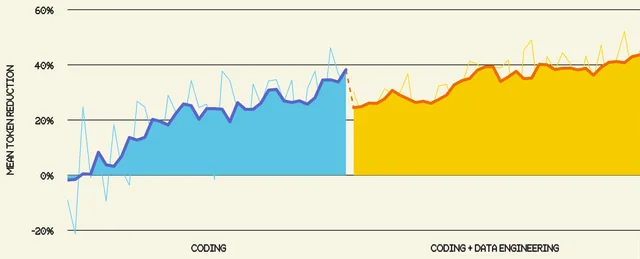
有用的细节在断点之前:第一段只训编码,模型在数据工程任务上已经省了约 20% 的 token。3
官方把这称作第一次看到泛化。
训练数据是自建的。任务按 Harbor 格式写,由 Terminus 2 agent 执行,每题配自动判分;数据由一套自动合成系统产出。3
策略更新用 GSPO:按整条序列加权与裁剪,不逐 token。官方说逐 token 的损失会震荡,最后发散。3
学习率固定 5e-5,并且照 Dr. GRPO 的做法,不按组标准差归一化优势。3
省下来的不只是钱。官方说任务也更快跑完,因为折在推理和返工上的时间同样被压掉了。3
质量:证据只到「没变差」
四个基准上,官方的措辞是 pass@1(一次尝试就通过的比例)落在基座的置信区间内。3
合起来看,Particle-1 通过率 72.57%,基座 71.15%;同图里的 GLM-5.3-Flash 是 66.82%。3
训练域外的四项也没涨:GPQA Diamond 90.40 对 90.91,Tau Airlines 86 对 88,MMLU 86.08 对 85.98,BabyVision with tools 89.18 对 89.60。3
都在一个点上下,意思是没退,也没有涨。
泛化的例子来自法务:Harvey LAB 的仲裁条款审查,读四份合同、比对仲裁机构规则、写 Word 报告。3
官方把适配器强度从 0.25 倍扫到 8 倍。1 倍时输出 token 少 24.6%,八份报告全部通过两个评审的全部标准。3
同一任务上,基座的准确率是 62.5%;8 倍时 token 少 78.7%,但只有三份过。3
样本量要记住:一个任务、八次运行。
OpenRouter 上只有一个供应商,就是它自己,延迟与吞吐两栏还是空的。10
今天能说的是:在官方自己那套 harness 上,它用更少的 token 拿到同一档分数。
这句话还不能读成「同质量更便宜」——质量那一半没人独立量过。
怎么接,边界在哪
接口 OpenAI 兼容,base URL 是
https://api.particle.ai/v1,模型 ID 是 particle-ai/particle-1,在 platform.particle.ai 注册、预付费充值。4结构化输出不做保证:json_object 接受,json_schema 原样转发但没有校验路径。5
上下文 1,048,576 是输入输出合计,输出上限 131,072。5
同一个基座在 DeepSeek 那边开到 384K 输出。7 长输出任务是硬差别。
它还转卖另外两个模型。DeepSeek V4.1 Flash 卖同样的 0.25 / 0.03 / 1.00。6
换句话说,它把自己后训练的模型和基座摆在同一个价目上卖,让用户直接比价。
该不该试
- 正在为编码 agent 的账单发愁:值得花半天。拿 20–50 条自己的真实轨迹,同一 harness 跑基座与 Particle-1,记输出 token、缓存命中率、每任务实付。命中率不到九成,它大概率更便宜;九成五以上,账会反过来。
- 只按跑分选模型:暂时没有可用的第三方分数,先别进候选表。89
- 有长输出任务:131,072 的输出上限是硬约束,基座在 DeepSeek 那边是 384K。57
- 在意供应商锁定:权重不开放,LoRA 也不发布,换供应商等于换模型。3
- 只是看行业动向:这家公司的判断值得记一笔——模型层的差距在收窄,钱该花在推理和成本上。2
还没有的数字
References
- 1Suhail on X
x.com
- 2About — Particle
particle.ai
- 3Introducing Particle-1 — Particle
particle.ai
- 4Particle Inference API
docs.particle.ai
- 5Model catalog
docs.particle.ai
- 6Usage & billing
docs.particle.ai
- 7Models & Pricing · DeepSeek API
api-docs.deepseek.com
- 8Artificial Analysis LLM Leaderboard
artificialanalysis.ai
- 9Vals Index
vals.ai
- 10Particle-1 · OpenRouter
openrouter.ai
- 11Data retention
docs.particle.ai
- 12Z.AI Pricing
docs.z.ai
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.