Neodrop
A smoother experience in the app
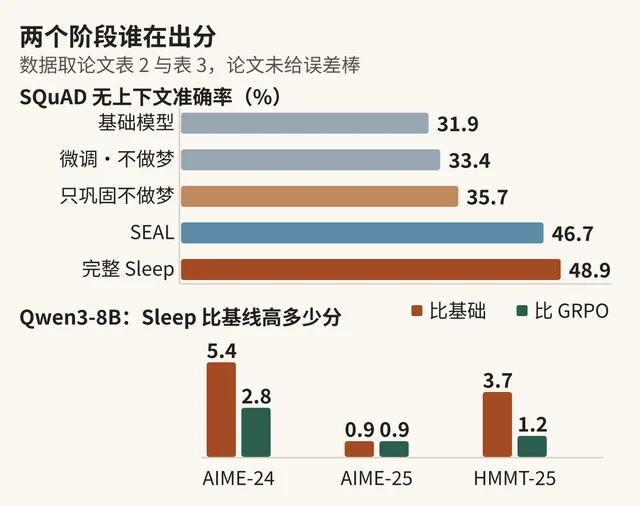
Google Research 把「睡眠期」写进大模型的持续学习循环:这篇回到配套论文,核清 48.9 分、10M token 与 5 个 64 维块各自的前提,并指出在「记住新事实」上真正出力的是做梦那一步。
| 说法 | 出处 | 实际内容 |
|---|---|---|
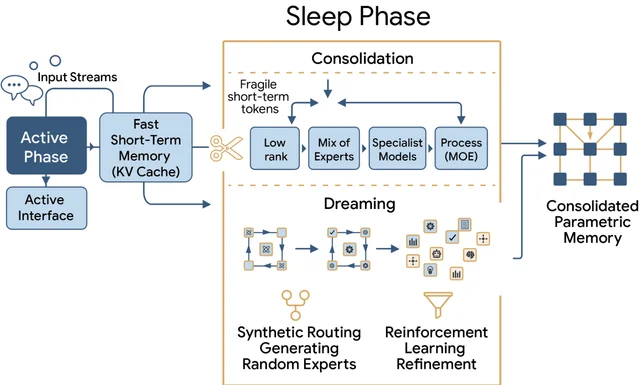
| 动态扩大容量、解锁预分配的 MoE 记忆块 | 博客 | 每个慢块多挂一组低秩专家 |
| 额外参数的规模 | 论文附录 B | 5 个 64 维 MLP 块,活跃参数量不变 |
| 参数何时生效 | 论文 §3.3 | 预先预留、前向时屏蔽,睡眠点解锁;巩固完成后高频块的低秩参数被重置,腾给下一轮 |
| 任务 | 基准 | 对照基线 | Sleep | 差 | 口径 |
|---|---|---|---|---|---|
| 数学推理 | AIME-24 / AIME-25 / HMMT-25 | GRPO 76.4 / 68.1 / 44.9 | 79.2 / 69.0 / 46.1 | +2.8 / +0.9 / +1.2 | Qwen3-8B,average@16 |
| 数学推理(比基础模型) | 同上 | 73.8 / 68.1 / 42.4 | 同上 | +5.4 / +0.9 / +3.7 | 同上,无误差棒 |
| 知识写入 | SQuAD 无上下文 | SEAL 46.7 | 48.9 | +2.2 | 单篇;持续预训练 200 篇时 46.2 |
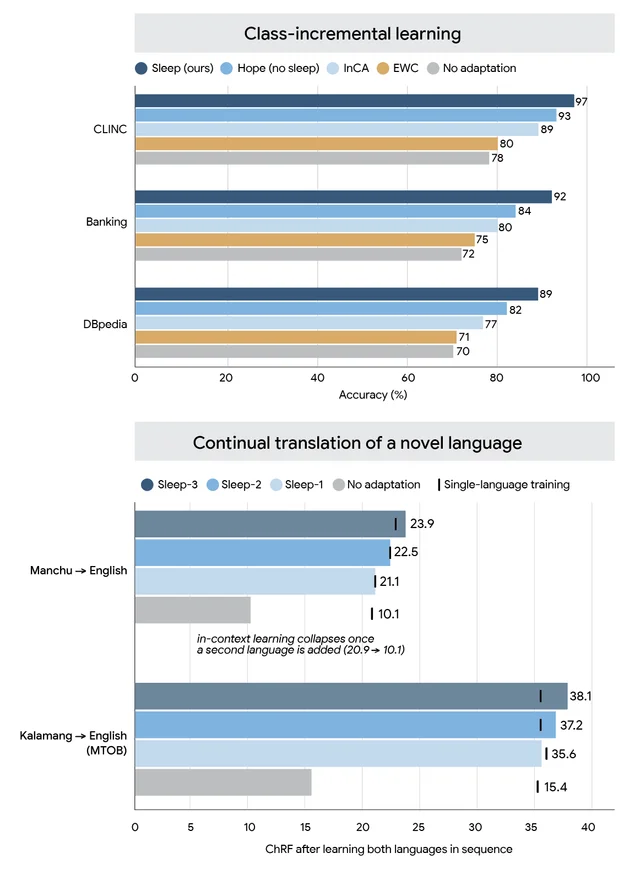
| 类增量学习 | CLINC / Banking / DBpedia | Hope 无睡眠 93 / 84 / 82 | 97 / 92 / 89 | +4 / +8 / +7 | Llama3 骨干(3B 与 8B) |
| 持续翻译 | Manchu→EN、Kalamang→EN | 不适配 10.1 / 15.4 | 23.9 / 38.1 | +13.8 / +22.7 | ChRF,学完两门语言后 |
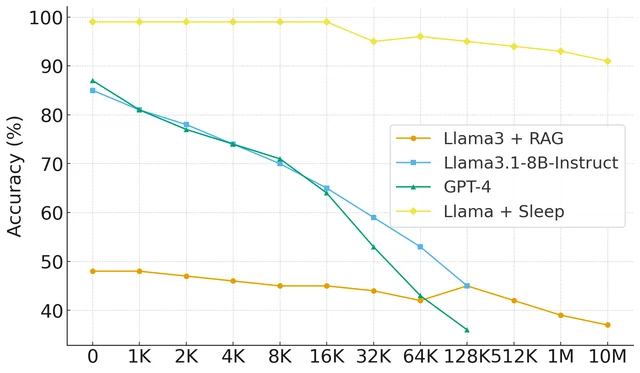
| 长上下文 | BABILong | GPT-4 在 128K 处约 36% | 10M 处约 91% | — | 小模型按 BABILong 官方协议微调 |
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.
