六类总体判对 90.2%,人工林只有 58.2%:Google 把全球森林类型做成了 10 米概率图
Google 把全球森林按 FAO 六类划成 10 米概率图,总体判对 90.2%;这篇拆开六类的真实得分:原生林 82.9、人工林只有 58.2,而 EUDR 要判的恰好是后者,以及三处会让合规答案偏离的地方。

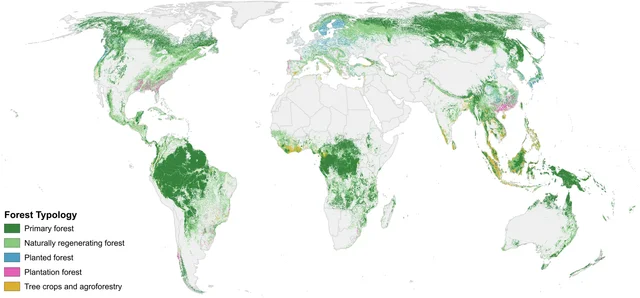
从太空看,一片原始林、一片桉树人工林、一片油棕园,都是「有树」的一格绿。1
欧盟的《无毁林产品条例》要的恰好是这格绿下面的东西:木制品不能来自被改成种植园的原生林,咖啡、可可、棕榈油不能来自 2020 年底之后由林转农的地。2
法规要判「什么林」,卫星只报「有没有树」。这中间的落差,就是这张图想填的。
10 月 21 日,Scientific Data 刊出这篇数据论文。作者来自 Google DeepMind 与 Google Research,合作方是世界资源研究所(WRI)和国际应用系统分析研究所(IIASA)。2
产品叫 Forest Typology(ForTy)v1,是一张 2020 年、10 米分辨率、把全球陆地分成六类的概率图。次日官方博客发布,一起上线的还有 2017–2025 的逐年序列,标注为早期版本。1
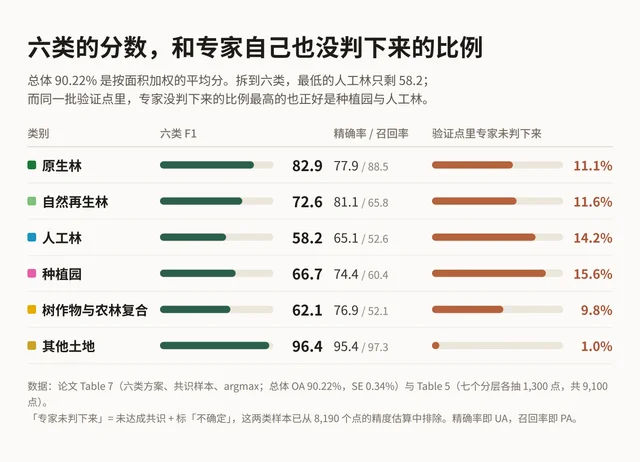
论文给的总体精度是 90.22%。拆开是:原生林 F1 82.9,自然再生林 72.6,人工林 58.2,种植园 66.7,树作物与农林复合 62.1,其他土地 96.4。2
下面只回答一件事:这张图哪一层可以直接用,哪一层不能。
FAO 按管理历史分类,卫星只看得到覆盖
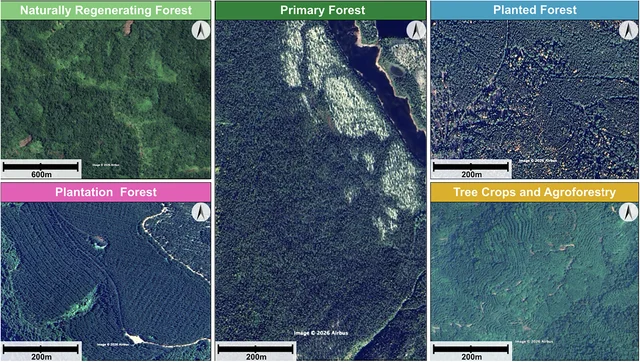
六类的定义照抄联合国粮农组织(FAO),也对着欧盟条例的用法。原生林是「没有可见人为干扰迹象的原生树种林」,自然再生林是人为干扰之后自己长回来的,人工林是人种下或播下的、经营周期较长,种植园是集约经营、一到两个树种、轮伐期不超过 40 年。
第五类是树作物与农林复合,油棕、橡胶、可可、果园这类不打木材的农地。剩下的都归其他土地。2
问题在于,前四类分的是管理历史与意图,遥感看的是当下的覆盖。
论文把困难拆成三条。成熟的本地树种人工林,在光谱上可以跟同龄的天然次生林一样。
火烧过的林子和采完待造林的地,按定义仍然是森林,在影像上却是裸地与冠层损失。人工林、种植园、树作物在热带冠层闭合快的地区,光谱和结构都咬得很紧。2
这不是「模型再大一点」能解决的事。要分开它们,得靠跨年份的线索——种植的行列、生长周期、收割节律——而不是某一年的颜色。
交付的是五波段概率,分类图要自己算
发布出来的是五个人造林与树作物类别的概率波段,8 位无符号整数、取值 0–250。第六类「其他土地」的概率是 250 减去前五个之和。3
想得到一张分类图,取六类分数里的最大值(argmax)就行,数据集的示例代码也是这么写的。3
全球陆地被切成 613 个 UTM 分片,每片一个 zip,里面是若干 Cloud Optimized GeoTIFF。
许可为 CC-BY 4.0,Figshare 可下载,Earth Engine 里也有镜像,覆盖 65°S–84°N。2
这是它跟上一代的分水岭。2025 年 11 月那版 Natural Forests of the World 2020 只回答一个问题:这块地在 2020 年是自然林还是不是。4
ForTy 把那一问拆成五问,还把答案从「标签」换成了「分数」。给分数而不是给标签,是个明确的产品选择,代价与收益留到后面两节说。
三级级联:45 万条人工标签撑起 120 万个 10 米小块
真正稀缺的是标签。高质量的森林类型参考数据多是点标注,一个点代表约 100 米见方内的主导类别,不是 10 米分辨率的密分割掩膜,而且地理上极不均匀。2
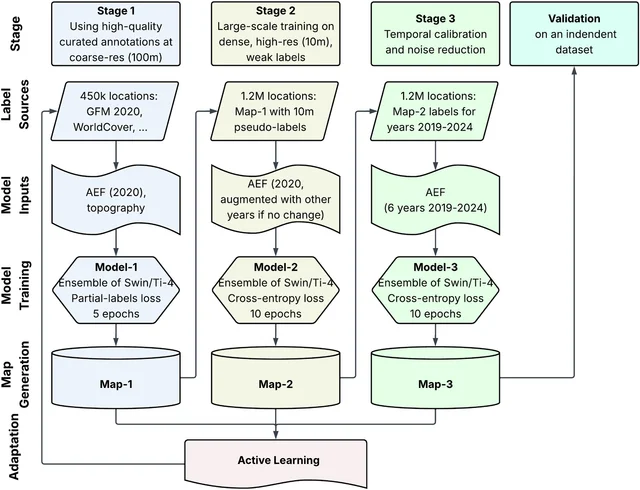
论文的解法是三级级联,每一级给下一级造标签。
第一级用 45 万条精编样本(GFM 2020、WorldCover 等),配上 2020 年的卫星嵌入与地形特征,用允许「部分标签」的损失函数训练,学会全局的类别模式。2
第二级把第一级的预测当成伪标签,用高分辨率辅助数据精修,扩到 120 万个 10 米密标小块,改用标准交叉熵。2
第三级把 2019–2024 六年的年度嵌入拼成六帧输入联合训练,做时间校准与降噪,同时保留真实的年度变化。2
模型本身不复杂:Swin Transformer v2 的 Tiny 版,五份独立初始化各训一次做集成,每份输出 128×128 像素(1,280 米见方)的分割。2
推理时相邻块中心间隔 210 米,重叠像素按到块心距离反比加权,把拼缝抹平。2
这里有个口径值得单独说清。摘要写的是「1.7 million samples」,博客写的是「约 170 万个标注点位」,而 Table 1 的标题把来源拆开了。2
第一级是 450,275 条参考样本;第二、三级用的是 120 万个 10 米小块,标签由第一级的预测加辅助数据精修而来。两数相加约 165 万,与 1.7 million 大致对得上。2
也就是说,真正由人标过的只有 45 万条,剩下四分之三是模型自己产的。这不是隐瞒,这正是级联方法的目的,但读者该知道自己读的「170 万标注」是什么成色。
主动学习补进来的是最后一层:三轮,共约 4.3 万条。
第一轮 22,131 条,主要修原生林与次生林的混淆(11,842 条,用专家核过的完整森林景观标签定案),以及东南亚、西非、南美的树作物漏检(7,254 条)。2
第二轮 1,016 条,盯中国、美国西北与东南、日本、智利、韩国的工厂化林。
第三轮 19,880 条,修的是反方向的错:欧洲葡萄园与印度西孟加拉香蕉园被过判成树作物,中美洲 Miskito 松林被判成人工林,加拿大、西伯利亚、土耳其、美国的原生林过判,非洲与印尼漏掉的油棕。2
修正方向是双向的,被点名的地点也具体到生态区。这说明错误是地理系统性的,不是随机噪声。
40 年轮伐期,是这张图最要紧的一次定义替换
前面说人工林与种植园靠管理强度分开:单一树种、同龄级、规整间距。这三样都拍不出来。
论文的办法是换一个能从多年时序里看出来的代理:轮伐期。超过 40 年的算人工林,40 年及以下的算种植园。2
作者自己把这层写进了正文与数据集文档,用词是「操作性的简化」。
它未必适用于所有生物群区、所有营林体系与各国的经营传统;40 年附近的轮伐期分不出管理强度,长期轮伐却高强度经营(或反过来)的林分照样会错。3
这一条比任何精度数字都值得记住。当监管说「人工林」与「种植园」是两类、后果不同时,这张图实际判的是「轮伐期长不长」。
判得准不准,取决于这个代理在你那块地上成不成立。
90.2% 是被「其他土地」撑起来的
验证用的是分层随机抽样:七个层(六类加一个「潜在森林」层)各抽 1,300 个点,共 9,100 个。2
两名受过训练的专家各自独立判读,看 30 米上下文窗和中心 10 米像素,分歧靠共识会议解决。报告里的精度全部基于中心那个 10 米像素。2
分层的意思,是总体精度按各层的面积加权。而权重最大的那一层是「其他土地」:7,644.6 百万公顷,占 13,374 百万公顷的 57%,它的 F1 是 96.4。2
论文自己的提醒是:总体精度受这个类别影响很大,用户应该去看与自己应用相关的那几类的 F1。2
森林侧的面积分配是这样的:原生林 2,123.7 百万公顷,自然再生林 1,797.9,人工林 204.7,种植园 118.0,树作物与农林复合 145.8。2
前四类合计 4,244.3 百万公顷,约占全球陆地的 31.7%。
逐类拆开,就是开头那组数。精确率与召回率的方向也不一样。
原生林召回 88.5 高于精确 77.9,说明它更少漏判、更容易多判。人工林精确 65.1、召回 52.6,两头都低——漏掉近一半,判成人工林的地里约三分之一不是。2
专家自己也没判下来的,正是那三类
那张图右列值得单独看。七个分层里,种植园未达成共识 163 个、人工林 146 个,而其他土地只有 12 个。「不确定」的分布同样偏:树作物 44、种植园 40、人工林 38,原生林 9、其他土地 1。2
论文对这件事的措辞很直白。
专家不确定性最高的地方,恰好是森林类型的区分取决于管理历史与土地利用意图、而非可观测冠层属性的地方——也正是遥感最难的那条边界;把这些点排除在精度估算之外,可能让精度估计略有偏差。2
这是作者自己写的偏差,不是外部指控。
它的分量在于:类别边界本身在摇,不只是模型在摇。当两名受训专家看着最高分辨率影像、多年时间序列和区域经验,仍在一成半的种植园点上给不出结论时,任何模型在这一档上的上限都不会太高。
跟 JRC 比赢了 3.1 个百分点,裁判是同一套
论文在同一套验证集上跟几个全球产品做了对照。
森林/非森林二分类:ForTy 95.5%,欧盟委员会联合研究中心的 JRC GFC2020 v3 是 93.6%,ESA WorldCover 2020 是 91.6%,ALOS PALSAR FNF4 是 86.9%。2
四类方案(原生、自然再生、人工、其他)对 JRC GFT2020:总体 90.9% 对 87.8%,差 3.1 个百分点。
逐类 F1 是原生 82.9 对 76.9(+6.0)、自然再生 72.3 对 66.7、人工 65.8 对 57.2(+8.6)、其他 96.7 对 95.3。这里的「人工」是人工林与种植园合并后的类。2
进步是真的,但要说清两件事。
一是裁判问题。这些对照都跑在自家那套 GVFT 验证集上,两个产品由同一批专家、同一套判读协议打分。
这在数据论文里是常规做法,但它不是中立第三方盲测。
训练数据里含 GFM 的标签,验证协议由作者设计,而 GFM 那篇的作者 Lesiv、Fritz 也在这篇的作者名单里。这套流程对「按 FAO 定义重新对齐过标签的模型」天然有利。2
二是分区读数里有些格子撑不住。六类总体从欧洲 88.5% 到南美 90.7%,看起来平;逐类差别大得多。
原生林 F1 南美 92.6% 最高,澳大利亚 65.8% 最低,而澳大利亚那一格只有 277 个样本。自然再生林在各洲之间最稳,62.5%–79.5%。2
还有三格的标准误大到不该被引用:澳大利亚的树作物只有 5 个参考点,非洲的人工林一个预测点都没有,欧洲的种植园 32 个参考点。2
阈值能换不能加,概率没有校准
发布概率而不是标签,是为了让使用者自己定操作点。论文 Figure 7 把这条权衡画了出来:横轴是置信阈值,纵轴是精确率与召回率,三条曲线分别是「全部自然林」「全部森林」「全部人工林」。2
前两条在高阈值处都还能维持八成以上。第三条不一样:阈值往上推,精确率缓慢爬到接近八成就见顶,召回率同步从六成多掉到四成。2
这条曲线没有两头都高的位置。做合规的人如果想「只接受模型很有把握的像素」,代价就是放弃一半以上的实际人工林。
更要紧的一条写在数据集文档与论文里:这些分数是五个模型 softmax 输出的算术平均,没有做后验校准。3
它应当当「相对置信度」用,不能当真实的类别后验概率;要拿它做定量风险评估,得用本地独立参考数据做区域重校准。2
换句话说:拿一个 0.73 去乘面积算「有多少公顷是原生林」,在这份数据上是不成立的算法。它可以排序、可以筛区域,不能直接当概率做积分。
三处会让答案变的地方
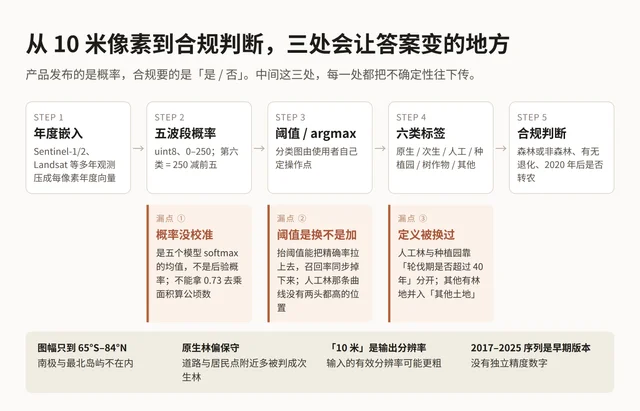
把产品到合规判断的路径拆成五步,会把不确定性往下传的地方只有三处,但每一处都不小。
第一处是概率没校准,上面已经说过。第二处是阈值只能换不能加:想要更干净的「是」,就得多接受一些「漏」。
第三处是定义被替换过,而且是三处替换叠在一起。
人工林与种植园的界线换成了 40 年轮伐期。「其他有林地」(OWL)被整体并入了其他土地,这意味着「原生林退化成疏林」在图上会表现为「森林 → 其他土地」,跟「林子被推平」混在同一条通道里。2
论文对此的建议是叠加能分辨 10% 郁闭度阈值的冠层变化产品来补。另外,采完待造林、扰动后早期这类按 FAO 仍算森林的地,也会因为单年观测被判成其他土地。2
还有一处方向性的偏差值得单列。原生林这一类在道路、居民点、农地附近偏保守。
原因是它继承了 GFM 训练数据的标注惯例,缓冲效应让模型系统性地把靠近基础设施的林缘排除在原生林之外,多数改判成自然再生林。3
也就是说,这张图对「人迹附近还剩多少原生林」是低估的。
逐年序列没有精度数字
博客最有分量的一句话,是「第一次能按年看到不是林子没了,而是什么替代了它」。1
它对应的是 2017–2025 的逐年序列:自然林被换成木材种植园、弃耕地慢慢长回森林,这些变化在只看树冠的图上根本显示不出来。
但这套序列目前只有产品级支撑。论文覆盖的是 2020 这一年的基线,第三级模型用 2019–2024 做时间校准,正文没有给出逐年序列的任何精度评估。2
博客的措辞是「早期版本」,未来几个月还会与伙伴和使用者一起改进。1
还有一个细节值得留意:作为输入的 AlphaEarth Foundations 嵌入,公开数据集覆盖的是 2017–2024 年,而序列写到了 2025。5
最后一年怎么来的,公开材料里没有交代。所以「2020 年后这块地有没有转农」这种判断,2020 那一端有论文与验证集兜底,2021 之后那一端目前只能算产品级证据。
这份数据该怎么用
论文自己给瑞典算了一笔账:约三分之二的森林面积被归为人工林或种植园,天然林只占国土面积的两成左右。2
对这样的国家,看总树冠覆盖率会得出「森林充足」的结论,看这一张图才知道天然林那一块有多薄。
用起来只有四条规矩,按代价从低到高排。
先确认你要判的是哪一类,然后只看那一类的数。90.2% 对任何具体应用都没有意义。
判「是不是森林」看 95.5%,判「是不是自然林」看 94.8%,判「是人工林还是种植园」就接受 58.2 与 66.7 这个量级。2
再确认这条边界在你的区域靠什么成立。40 年轮伐期这个代理,在巴西的大豆带、印尼的油棕带、瑞典的林业区含义完全不同,先找本地的已知地块核对,比看全球平均有用。
然后才是定阈值。要精确率就抬阈值,要召回率就压低,但别指望两者同时改善。
最后,凡是要出金额或面积数字的场合,先做区域重校准,或者至少把概率当序数用。3
要去读原文的话,四节最值:Limitations 一节把这张图的边界一次写完,Table 5 的未解决分布是全文最诚实的一张表,Table 7 是那个 90.2% 的拆解,Figure 7 是阈值权衡的原始曲线。2
代码在 google-deepmind/geeflow 与 google-deepmind/jeo 两个仓库,训练与推理都跑在 Earth Engine 上。2
它的分量在于把监管定义变成了可计算的图层
Google 的地球 AI 这两年分成几支:能预测的基础模型、会调工具的地理空间智能体、以及一层层往上叠的数据集。ForTy 属第三支。1
它不回答「这片林子会怎么变」,只回答「2020 年它被归为哪一类,置信度多少」。这个定位决定了它的价值与天花板。
价值是:以前只有法规文本和国别统计能回答的问题,现在有一张全球一致、10 米、开放许可、带概率的底图可以对着看。
天花板是:法规判的是管理意图,图给的是可观测代理。两者之间那几次替换——40 年轮伐期、OWL 并入其他、单年观测——不会因为分辨率更细而消失。
要让这张图真正进合规流程,缺的不是把 58.2 提到 80,而是把「哪几处替换被接受」写成公开约定:用哪一年做基线、退化怎么算、概率到什么水平才算证据。
在那之前,这张图该被当成一份把监管语言翻译成数据和概率的初稿:范围缩得很准,结论还得自己校准。
References
- 1Beyond tree cover: mapping the world's forest types
deepmind.google
- 2
- 3Forest Typology (ForTy) 2020 v1.0 | Earth Engine Data Catalog
developers.google.com
- 4
- 5
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.