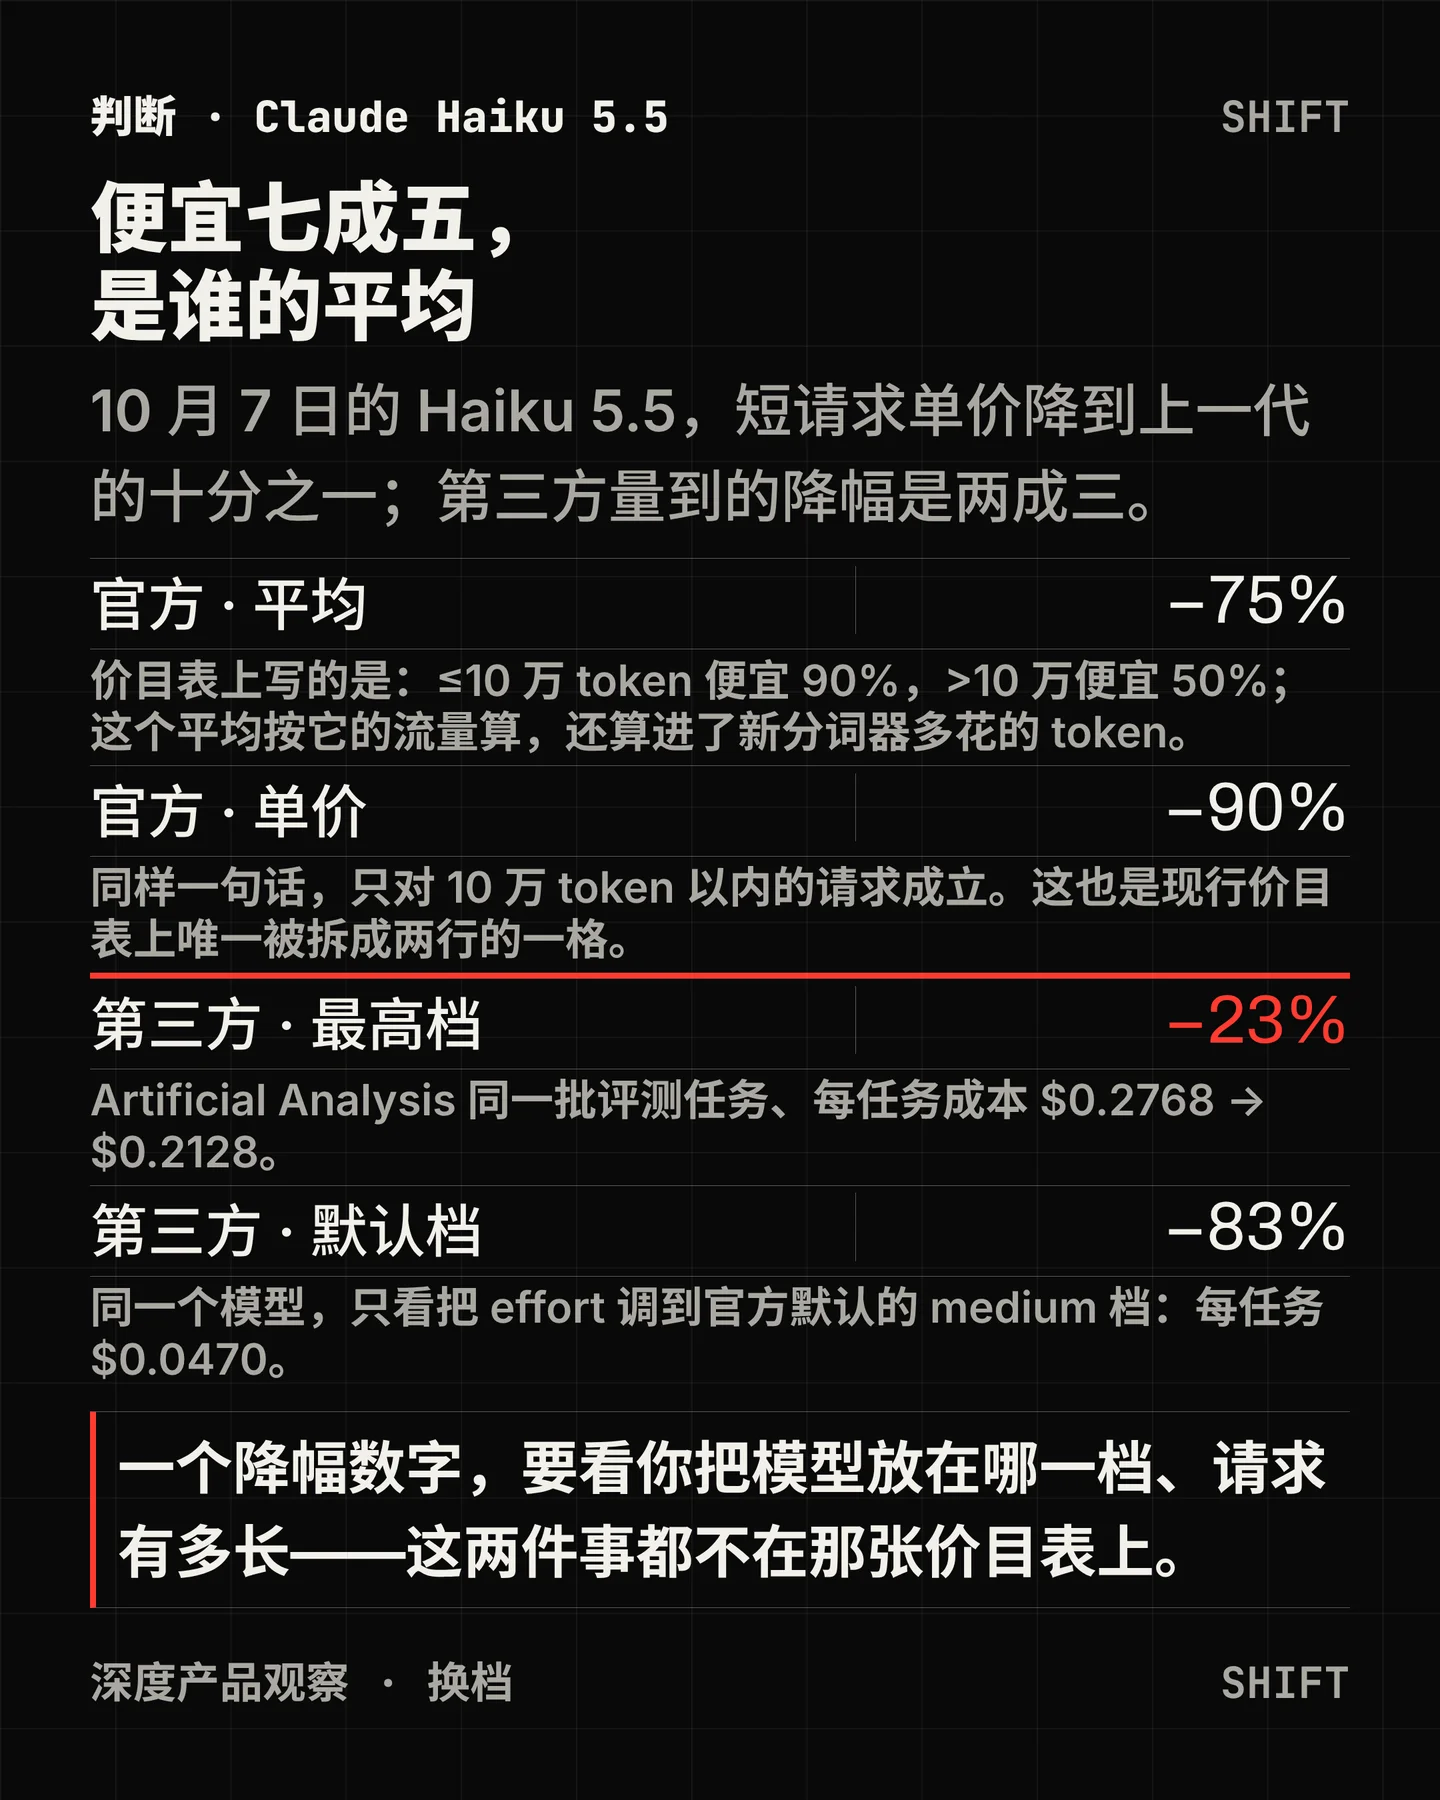

Anthropic 在北京时间 10 月 8 日凌晨 2 点发布 Claude Haiku 5.5,把它说成「我们发布过的最便宜、最快、能力最强的小模型」,并给出一个数字:平均而言,跑同样的活便宜约 75%1。同一页的价目表给出的却是另外两个数——10 万 token 以内的请求便宜 90%,超过 10 万便宜 50%。
这两个数不矛盾,但它们说的不是同一件事。下面把那个 75% 拆开:它由三件在价目表上看不全的事决定——你的请求有多长、你把 effort 放在哪一档、新分词器会把同一段文字算成多少 token。拆完再看外面量到了什么。
先把时间钉住
发布页只印着「October 7, 2026」,没有可读的发布时间字段,也没有 RSS,sitemap 里这一条没有 lastmod。可核的锚点在别处,而且互相独立:官方发布帖的页面元数据是 10 月 8 日 02:01:16,Hacker News 主帖
49996437 创建于 02:01:32,OpenRouter 上架 anthropic/claude-haiku-5.5 记录的时间戳是 02:31:232。那条发布帖挂在 @claudeai 账号上。另外两条锚点值得记下来,因为它们是「第三方什么时候开始测它」的起点:平台文档页被提交到 Hacker News 的时间是 01:56:14,比发布帖早五分钟;Artificial Analysis 的模型页被单独提交是 03:16:18。
那个 75%,是一个加权平均
官方发布页的脚注 2 把算法写出来了,逐字是:10 万 token 以内的请求比 Haiku 4.5 便宜 90%,超过 10 万便宜 50%;在 Haiku 4.5 上,90% 的请求落在前者;而「这个计算也算进了 Haiku 4.5 与 Haiku 5.5 之间、完成同一件活所需 token 数的变化」——Haiku 5.5 换了更新的分词器,每任务用的 token 略多1。
三件事叠起来才是那 75%:两个不同的折扣率、一个按请求数统计的流量比例、以及一个把折扣往回吃掉一点的 token 变化。官方没有公布这三个数各自的权重,所以 75% 严格来说属于「对它自己的流量成立」的估算,不是一条可以搬到别人账上的公式。The Decoder 的判断也是这个方向:
Real-world savings are likely smaller than the per-token prices suggest.(真实世界的节省很可能小于单价看上去暗示的幅度。)3一个更容易查证的推论是:如果你的产品恰好是那种要往上下文里塞长文档的类型,你拿到的不是 90%,是 50%。
三处会让账单移动的地方
第一处:请求长度。 Haiku 5.5 的每一行价格都被拆成两档,阈值 10 万 token,倍率正好 5 倍:输入 $0.10 → $0.50,输出 $0.50 → $2.50,5 分钟缓存写 $0.125 → $0.625,1 小时缓存写 $0.20 → $1,缓存读 $0.01 → $0.05。批量价同样分两档,$0.05/$0.25 与 $0.25/$1.254。
这件事为什么值得单独说:在同一张价目表上,它是唯一被这么拆的模型。定价页逐字写着,Claude 4.6 及之后的模型(Claude Haiku 5.5 除外)以及 Claude Mythos Preview,整个 100 万 token 上下文都按标准价计费,「一条 90 万 token 的请求,和一条 9 千 token 的请求按同样的每 token 单价计费」4。也就是说,别的模型没有这条线,它有。Hacker News 上一条被顶得很高的评论把这个边界说得更直白:10 万 token 是个低得离谱的阈值,做 agent 很快就会越过去,而且这条线只对 Haiku 生效,Sonnet 和 Opus 都没有2。
系统卡里对应的一句是:
Claude Haiku 5.5 is charged per request at the rate for that request's prompt length (above or below 100K tokens).5第二处:effort。 Haiku 5.5 是 Haiku 级别里第一个带可调 effort 的模型,官方支持
low、medium、high、xhigh、max 五档,默认是 medium——和 Opus 5.5 同一个默认值,而其余支持 effort 的模型默认是 high6。官方对 effort 的定义是控制「回应时花多少 token」,代价与收益都落在 token 上;发布页给的三张 accuracy-vs-cost 曲线也只画到这一层。第三处:分词器。 平台模型页逐字写着:Haiku 5.5 用的是与 Claude 4.7 及之后模型相同的新分词器,「同样的文本在它这里算作大约多 30% 的 token」7。价钱按 token 算,所以字数不变也照样要多付。同一页还提醒,为 Haiku 4.5 调好的
max_tokens 可能把输出截断——这条是给迁移的人看的。外面量到的只有一条
到发稿时,对这款模型做过独立测量的机构只有一家。
Artificial Analysis 在指数 v4.3.2 下给出 Haiku 5.5 的读数:智能指数 43.4,每任务成本 $0.2128,每任务输出 162,164 个 token8。它的对手是同一家机构测过的 Haiku 4.5 推理版:指数 16.9,每任务 $0.2768,每任务输出 18,485 个 token9。
把这两个数放在一起,得到的是便宜约 23%,不是 75%。差距的来源是看得见的:每任务输出 token 是上一代的 8.77 倍,把「每个 token 便宜十倍」吃掉了一大半。AA 的成本分项里,只有缓存读那一项比上一代贵(2.65 倍),其余三项都便宜——非缓存输入 0.19 倍、缓存写 0.25 倍、输出 0.88 倍。
但这里必须说清楚口径差别:AA 测的是它自己那批固定任务,在
max 档上跑;官方那 75% 说的是真实流量混合的估算。两者不是同一个分母,所以「23% 对 75%」不是一个把另一个推翻,而是同一件事在两种设定下的两个读数。AA 自己就提供了这个对照。同一个模型换成别的档位,每任务成本是:
medium $0.0470、high $0.0794、xhigh $0.1238、max $0.2128。拿同一个 Haiku 4.5 推理版做分母,四个档的降幅分别是 83%、71%、55%、23%。官方那个 75%,正好落在 medium 与 high 之间——而它没有说自己用的是哪一档8。同一个模型、同一批任务,降幅从 23% 到 83%,这个区间比任何单个数字都更值得记住。
「最便宜」这条定位在 AA 的同批榜上也不成立:每任务 $0.0678 的 GPT-6 Luna 比 Haiku 5.5 的最高档便宜约 3.1 倍,而且两者的单价在 10 万 token 以内完全相同($0.10 / $0.50);指数 46.3 的 mimo-v2-6-pro 每任务只要 $0.1332,比它更聪明也更便宜8。VentureBeat 的说法更克制:新的价格让 Haiku 在市场上有了竞争力,但并没有让它成为市面上最便宜的选项10。
「最快」这条到今天还没有第二家量过。AA 页面里 Haiku 5.5 四个档位的速度与首字节字段都是空的,说明它还没有发布这款模型的吞吐读数;而同一批数据里 Sonnet 5.5 是 125.0 token/秒、GPT-6 Luna 是 127.98。VentureBeat 也写明,在它查阅的材料里 Anthropic 没有给出任何 token/秒的数字10。公开可查的、带数字的说法目前只有个人实测:一位开发者在 Hacker News 上贴了同一道题两个档位的结果——
low 档 7 秒、0.0936 美分,max 档 5 分 9 秒、3.3826 美分,同一件事差了约 36 倍2。至于官方自己公布的 benchmark 表,成绩是清楚的,条件也要一起读:GDPval-AA v2.1 从上一代的 735 升到 1620,AA-Briefcase 从 614 升到 1578,OSWorld 2.1 离线子集从 15.7% 升到 72.4%,Humanity's Last Exam 无工具从 10.2% 升到 45.9%,Terminal-Bench 4.0 从 0.0% 升到 39.2%1。系统卡说明这些数字取的是「adaptive thinking 在 max effort、默认采样设置、五次取平均」5。同一张表里,Sonnet 5.5 在 Terminal-Bench 4.0 上是 70.6%,在 HLE 上是 56.9%——官方自己也写明白了:复杂的 agentic coding 仍然该交给 Sonnet 5.5 与 Opus 5.5,Haiku 5.5 适合的是「本来会因为太贵而不做的、范围更窄的活」,比如压缩上下文、摘要和子代理。
这次降价放在什么时候看
Reuters 把这条发布放在两个背景里:这是 Claude 5.5 家族的第三款模型,时间点在公司计划上市之前11。而小模型这一档的价格战本来就在打:The New Stack 在报道里把 Google 的 GLM-5.3-Flash 和阿里国际站的 Qwen3.7 Flash 拉进来对照——后者的输入价是每百万 token $0.03 起,只在 3.2 万 token 以内的输入上成立12。
所以这一期的价格变化不能只读成「某家降价了」,它同时是一次定位调整:把最便宜的一档压到与对手同价,同时用一条长度分界线把那部分成本收回来。
同一天还有两件事
第一件是缓存读降价:Sonnet 5.5 的缓存读从 $0.20 降到 $0.10,按官方的说法,这让 Sonnet 5.5 在多数 agentic 任务上便宜约 20%1。它和 Haiku 5.5 的降价是同一天生效的,所以「该用哪个模型」这条线的位置两边都在动:小模型向下走,中模型也因为缓存变便宜而向下走。
第二件是订阅者的额度:Max 与 Team 订阅现在每月带 Claude Platform 的 API 额度,Max 5x 是 $100、Max 20x 是 $200、Team 按席位池化、上限 $500;Standard 席位 $20/座、Premium 席位 $100/座,新订阅者要满七天才能领取。这笔额度不能用在交互式的 Claude Code,也不能用在 Bedrock、Vertex 或 Foundry 上13。
换过去要改的不止一行模型 ID
Haiku 5.5 走的是一份十项的迁移清单,其中几项会让现有代码直接报错14:
- 手工 thinking 预算失效:
{"type": "enabled", "budget_tokens": N}一律返回 400,要改成{"type": "adaptive"};而 adaptive thinking 默认开着,回复可能直接以 thinking 块开头。 - 采样参数被移除:
temperature、top_p、top_k三个都不能用。带上temperature必须是 1,带上top_p必须是 0.99,其它值——包括top_p: 1、任何top_k、以及同时带temperature和top_p——一律 400。 - assistant prefill 被拒:上一代在关掉 thinking 时接受预填,这一代直接返回 400,即使 thinking 关着。
- computer use 换接口:必须从
computer_20250124换到computer_toolset_20260801,声明旧接口同样返回 400。 - Priority Tier 不支持:在 Haiku 4.5 上有 Priority Tier 容量承诺的组织,要另行安排容量。这一条不是代码问题,是采购问题。
- 没有服务端回退:分类器判定拒绝时,请求就停在那里;设置
fallbacks: "default"也不会转到别的模型,给一串回退模型名同样返回 40015。
最后一条在系统卡里有量化的后果:在 Terminal-Bench 4.0 上,拦截发生在 1.8% 的试验里(660 次中的 12 次),而这些试验全部失败;Terminal-Bench-Science 是 2.3%(700 次中的 16 次)。系统卡写明,Haiku 5.5 的 cyber 与 bio 分类器都没有回退目标模型,被拦下就是被拦下5。
安全侧也有反方向的数字:单轮有害请求的无害响应率在 API 上是 98.39%(Haiku 4.5 是 97.23%),过度拒绝率 0.17%(Haiku 4.5 是 0.44%);在 Gray Swan 的间接提示注入测试里,它被攻破的比例是 0.08%(Haiku 4.5 是 58.40%)5。防护口径上,cyber 侧比 Haiku 4.5 严、但仍比最近几款其他模型宽——它放行更多防御类任务,不过仍然拦住渗透测试1。
谁会受影响
在 Haiku 4.5 上跑量的人是这一期最直接的读者,而对他们有用的动作不是「换不换」,是「先算一遍」。三件事要重算:同一段文字在新分词器下大约多 30% 的 token;你的请求里有多少落在 10 万 token 以上(那一部分拿的是 50% 而不是 90%);以及你打算把 effort 放在哪一档——默认的
medium 和为了迁移省事直接照抄的 max,成本差 4.5 倍。做 agent 的团队要做的判断更窄:官方自己把复杂 agentic coding 留给 Sonnet 与 Opus,把 Haiku 5.5 放在压缩、摘要、子代理这些位置上。同一天 Sonnet 5.5 的缓存读减半,意味着「把长上下文留给中模型、把小活丢给小模型」这个分工比上周更划算了一点。
采购与负责验收的人能带走一个具体的问题:这个降幅是在哪个 effort 档、哪一段请求长度分布上算出来的。官方没有给这两个前提;而对一个每天要处理几亿 token 的组织来说,这两个前提决定的钱,比 75% 与 23% 的差别还大。
做评测的人面对的是一片空白:v4.3.2 的独立读数只有一条,另一家评测机构 Vals AI 到发稿时还没有收录这款模型,速度字段两边都没有。要判断「最快」这句话是不是真的,今天没有别人量过的数字可以用。
到发稿时还没落定的
几个必须带着读的限制。第一,官方那 75% 与第三方的 23% 不是同一个分母:前者是厂商对自己流量混合的估算,后者是一家机构在一批固定任务上、取最高档跑出来的加权成本。两者都成立,都不能单独回答「我的账会降多少」。第二,恰好 10 万 token 的请求怎么计费、阈值按哪一类 token 判定,官方材料没有写——VentureBeat 在表注里明确指出了这一点10,第三方也没有人复算过。第三,没有任何第三方把这条分界算成具体金额:5 倍这个比例有四家提到过,但没有一家给出「一条 20 万 token 的请求在两档下各花多少钱」的绝对数字。
还有几处是公开记录里的空白:定价页没有自述的最后更新日;发布页没有逐字的 effort 档位清单;官方从未明文说 effort 只影响 token 数量而不改变单价;「Claude 进入 Google Docs / Sheets / Slides」这条同期流传的说法,在 Anthropic 的新闻列表与 sitemap 里都查不到对应的官方页面。媒体这一侧,被点名的十家里只有 The Verge、VentureBeat、The Decoder、The New Stack 与 Reuters 发了稿(另有 Yahoo Finance 一篇),而且没有一家做过独立复算;那份十项迁移清单,公开报道里只有一篇 Substack 长文提到过。
最后一件值得放在这里:发布当天,Claude 平台出过一次用量计量类故障——Claude 官方论坛的置顶帖记录了这一条,指向状态页上的三次更新(北京时间 10 月 7 日 21:25、10 月 8 日 00:36 与 01:28)。这与 Haiku 5.5 没有因果关系,但放在一个把「按 token 计费」当成核心变化的日子里,是个需要并排看的巧合。
References
- 1Introducing Claude Haiku 5.5|Anthropic
anthropic.com
- 2Claude Haiku 5.5|Hacker News
hn.algolia.com
- 3
- 4Pricing|Anthropic 平台文档
platform.claude.com
- 5Claude Haiku 5.5 System Card|Anthropic
anthropic.com
- 6Effort|Anthropic 平台文档
platform.claude.com
- 7Claude Haiku 5.5 模型页|Anthropic 平台文档
platform.claude.com
- 8Claude Haiku 5.5|Artificial Analysis
artificialanalysis.ai
- 9Claude 4.5 Haiku (Reasoning)|Artificial Analysis
artificialanalysis.ai
- 10
- 11
- 12
- 13
- 14Migration guide: Claude Haiku 4.5 to Claude Haiku 5.5|Anthropic 平台文档
platform.claude.com
- 15Refusals and fallback|Anthropic 平台文档
platform.claude.com
Comments