AI Agent 运营工具周报:从热榜、舆情到搜索需求,6 个接住动笔之前的入口
动笔之前这一段该看什么:按「热榜、舆情、搜索需求」三段盘点 6 个能被 Agent 直接调用的信号入口,逐个给出接入形态、数据来路与硬边界,并排出从零到有的安装顺序。

上期停在内容发出去之后,看的是评论、私信和转化数据怎么读回来。这一期往前挪到最前面:稿子还没写的时候,先知道这周该写什么。
动笔之前这一段,过去靠人刷。刷微博热搜、翻小红书上的同类笔记、在搜索框里试几个词,看到什么写什么。
要把它变成一条能重复跑的链路,得先解决三件事:公域热榜的数据从哪来,大家对这个话题怎么评价,有多少人真的在搜。
这 6 个入口就落在这三件事上,选型的第一个分岔口是数据来路和部署形态。
热榜这一层有三个入口,一层压一层。最底下是一条谁都能调的公开接口,中间是一座可以自部署的阅读站,最上面那套推送系统默认吃的正是中间那座的接口。
舆情和需求各自只有一个入口,一个把分析放在你自己的机器上,一个把数据留在别人的服务里。
最后一个想用一个 Agent 把五步串完,安装链也最长。
| 入口 | 一句话定位 | Agent 接入形态 | 信号来路与工序位置 | 硬边界与成熟度快照 |
|---|---|---|---|---|
| DailyHotApi 今日热榜 | 把几十个平台的热榜收成一个接口 | HTTP API,另带 RSS 模式 | 热榜:公开数据接口,自部署或直接调 | MIT;最近一次提交停在 2026-03-11 1 |
| newsnow | 可自部署的实时热点阅读站 | 自建站点,官方配 newsnow-mcp-server | 热榜:数据源层,也是 TrendRadar 的上游 | MIT;README 说明 NewsNext 换代、不再接受贡献 2 |
| TrendRadar | 把热榜按关键词筛完,再按点推到手机上 | GitHub Actions / Docker / 本地部署,另配 MCP 镜像 | 热榜:聚合 + 筛选 + 推送,吃 newsnow 的 API | GPL-3.0;v6.10.0、MCP v4.1.0,最近提交 2026-10-10 3 |
| 微舆 BettaFish | 多 Agent 舆情分析,从一句提问到一份 HTML 报告 | 纯 Python,Docker 构建;Flask 应用加多 Agent | 舆情:自建分析端,另接模型与搜索通道 | GPL-2.0;v1.2.1,最近提交 2026-10-01 4 |
| seodata.dev | 关键词的月搜索量、CPC 与竞争度,Agent 直接查 | REST,加远程 MCP(Streamable HTTP) | 需求:托管数据服务,按次计费 | 匿名 20 次/天,注册后 500 次/月免费,4.99 美元/月不限量 5 |
| Easel | 一个 Agent 串完发现、策划、创作、发布与归因 | OpenClaw Agent 加 Web 工作台,Python 3.10+ | 全链路:跑在本机,模型 Key 自己配 | Apache-2.0;113 个技能,小红书自动发布有风控提示 6 |
表里的 star 数与最近提交取自 2026 年 10 月 12 日打开仓库时的页面快照,只反映当时的状态。
先接热榜:一条接口,一座阅读站,一套推送系统
热榜决定了后面所有筛选和推送的原料。这三个入口处在同一条链的三层上,各管一段。
DailyHotApi:一个 JSON 地址,把几十个榜单收进来
imsyy/DailyHotApi 把热门数据收成一个接口。同一个地址既能返回 JSON,也能按 RSS 模式输出,方便塞进自己的脚本或阅读器 1。它维护的榜单很多。哔哩哔哩热门榜、微博热搜、知乎热榜、百度热搜、抖音热点榜、快手热点榜都在里面 1。
部署要走的路也短。Docker 镜像和 npm 包都发了,仓库另带一条 GitHub Actions 流程 1。
不想自己跑的话,作者挂了一个示例站点在
hot.imsyy.top 1。- 典型使用场景:给每日播报脚本喂输入,早上拉一遍微博和知乎;或者只取两三个榜,做同一条新闻在不同平台的热度对照。
- 安装与接入:
docker compose up,或部署到 Vercel,也可以直接调作者示例站的接口。 - 硬边界:MIT 许可。仓库最近一次提交停在 2026 年 3 月 11 日 1。接进流程之前,先跑一遍自己最需要的几个榜,确认返回里还有数据。
newsnow:把热榜做成一座自己的阅读站
newsnext/newsnow 是一个实时热点阅读站,按来源分栏,界面干净。它默认 30 分钟缓存一次 2。抓取间隔会按各源的更新频率自适应,作者写明最短 2 分钟,用来减少被目标站点封 IP 的机会 2。
部署走 Cloudflare Pages、Vercel 或
docker compose,登录与缓存都是可选项。仓库用 TypeScript 写,增删数据源的目录也分列出来了 2。- 典型使用场景:当作团队内部的一块热点看板;或者只把 MCP 挂进对话客户端,让 Agent 替你查某个来源今天在热什么。
- 安装与接入:fork 后导入 Cloudflare Pages 或 Vercel,需要登录同步就配 GitHub OAuth;自托管用
docker compose up。 - 硬边界:MIT 许可。README 里挂着一条状态说明:下一代版本 NewsNext 正在开发,作者已经不再接受社区贡献和 PR 2。这个 22,008 star 的项目现在能跑,后续维护要看换代版本。
TrendRadar:聚合、筛选、推送,一套自己跑的定时任务
sansan0/TrendRadar 把前面两件事合起来做成一套系统。它聚合多平台热点和 RSS 订阅源,按你设的关键词筛出真正关心的条目,再按点推到手机上 3。README 把它写成「最快 30 秒部署的热点助手」,版本号 v6.10.0 3。
它的数据来路值得单独记一笔。README 的致谢里写明,多平台数据走的是 newsnow 项目的 API 3。
想换数据源,配置里的
api_url 可以指向你自己部署的 newsnow 3。上一节那座阅读站因此成了这套推送系统的上游。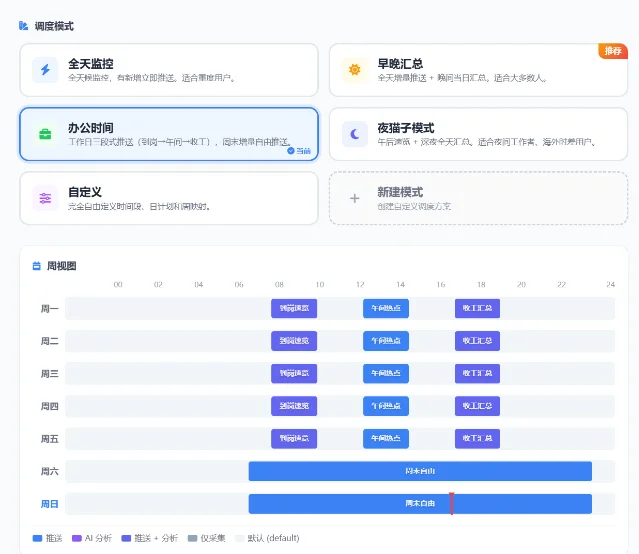
_image/editor.png。画面里是调度模式和一整张周视图:全天监控、早晚汇总、办公时间、夜猫子模式四套预设各配一段节奏,周视图把周一到周五的「到岗速览」「午间热点」「收工汇总」落到具体时段上,周六周日整条留白标成「周末自由」。这套工具回答的第一个问题是什么时候推。3推送渠道铺得很开。企业微信、个人微信、钉钉、飞书、Telegram、邮件都接,ntfy、Bark、Slack 和一个通用 Webhook 也在列表里 3。
筛选之后还有几层 AI 处理可以开:智能筛选新闻、多语言翻译,以及一份分析简报 3。
部署方式有五种:GitHub Actions、GitHub Pages、Docker、本地、Cloudflare Pages 3。
MCP 这一侧是独立的一套。TrendRadar 自己维护一个 MCP 客户端,版本号已经走到 v4.1.0。
它还发了一个独立镜像
wantcat/trendradar-mcp,通过 HTTP 的 3333 端口提供服务,可以和推送服务分开重启 3。从工具名能看出它给 Agent 留的口子:搜索新闻、分析话题趋势、分析数据洞察、分析情感倾向。四个动作都围绕它自己已经收下来的热榜数据展开 3。
- 典型使用场景:只关心三五个关键词的团队,让它每天早晚各推一条筛过的简报;或者把 MCP 挂进对话客户端,问「这个话题这一周是持续热还是一阵风」。
- 安装与接入:fork 仓库后跑 GitHub Actions 最省事;想控制频率和数据存放位置,走 Docker 或本地部署,官方文档站有分步说明 7。
- 硬边界:GPL-3.0,改过之后对外分发要按同协议开源。它默认吃 newsnow 的公共 API,README 专门写了一句提醒控制推送频率 3。
热度之外:这些人到底在说什么
热度只告诉你量级,评价得另找地方。这一段只有一个入口,它自己跑分析。
微舆 BettaFish:多个 Agent 开一场会,出一份舆情报告
666ghj/BettaFish(中文名「微舆」)是一套多智能体舆情分析系统。你提一个分析需求,几个 Agent 分头干活,最后生成一份可交互的 HTML 报告 4。三个 Agent 并行起手。Query Agent 管国内外网页搜索,Media Agent 管多模态内容,Insight Agent 管私有数据库挖掘 4。
它们各自循环「搜索—分析—反思」。中间由一个 Agent Forum 和一位 LLM 主持人把三方的发现摊开来互相质询,最后交给 Report Agent 汇总 4。
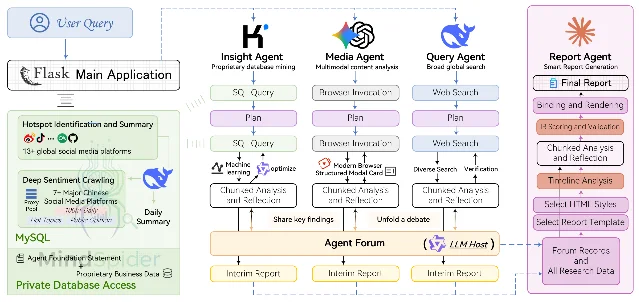
static/image/framework.png。图里从左到右是一条单向链路:用户提问先进 Flask 主应用,三个 Agent 各自带着 SQL 查询、浏览器调用和网页搜索并行循环,中间横向的 Agent Forum 承接三方发言并给出主持人引导,三个 Interim Report 汇到最右侧的 Report Agent,再经 IR 评分、时间线分析和装订渲染输出最终报告。4覆盖面是它比较硬的一块。README 说它自动分析国内外 30 多个主流社媒和数百万条大众评论 4。
仓库的架构图另给了两个数:7 个以上的中文社媒平台,以及每天十万条以上的处理量。短视频内容也在解析范围内 4。
它另外留了一条接私有库的口子,可以把内部业务数据和舆情数据放在一起分析 4。
整套东西是纯 Python 写的,一键部署。作者也说明,改一改 Agent 的工具集参数和提示词,就能把它挪到别的分析场景 4。
- 典型使用场景:一个新概念出来,先摸清微博、小红书、抖音上的主流说法和情绪分布;或者做竞品品牌的口碑盘点,把公开评论和自家客服记录放在一起看。
- 安装与接入:README 提供 Docker 构建;仓库里有一份以「武汉大学舆情」为例跑出来的完整报告,另有一个完整运行的视频可以对照 4。
- 硬边界:GPL-2.0,最近提交 2026-10-01。它跑起来要配模型 API,联网搜索、文件解析和网页抓取走的是另外的外部通道,README 里这些通道由赞助商提供 4。一次分析要循环多轮,耗时和调用成本先估一遍再上。
把猜测换成搜索量:seodata.dev
seodata.dev:写之前先看一眼,这个词有几个人在搜
seodata.dev 只回答一个问题:一个关键词有多少人搜、点一次要多少钱、竞争有多激烈。它给每个词返回月搜索量、CPC 和 0 到 1 的竞争度,覆盖 50 多个国家 5。给 Agent 的入口是两个。一个是 REST:
GET /v1/keyword?q=关键词&country=us 5。另一个是远程 MCP,地址
https://mcp.seodata.dev/mcp,走 Streamable HTTP,没有登录也能用 5。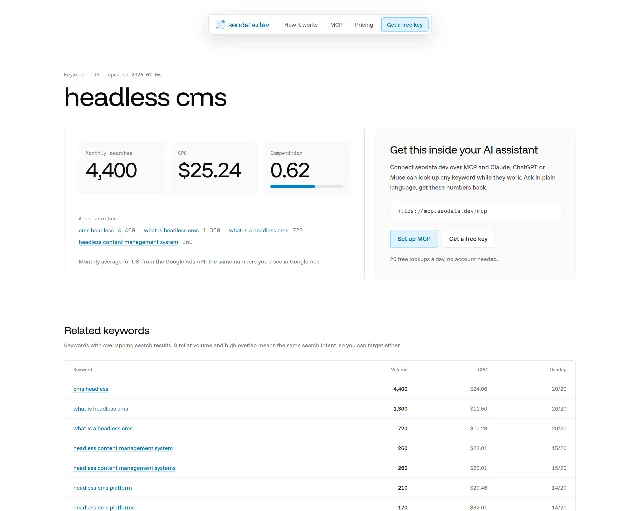
https://mcp.seodata.dev/mcp 和「20 free lookups a day, no account needed」直接写在页面上。8额度分三档。不注册匿名每天 20 次,按 IP 计;注册后每天 50 次、每月 500 次免费;不限量是每月 4.99 美元 5。
数据库里已有的词不限次。新词每个账号每天另有 10,000 次的上限,超出后接口返回 429 5。
- 典型使用场景:定下选题之前,比几个候选词的真实搜索量和难度;或者一次比一批长尾词,挑竞争度低的那几个动手写。
- 安装与接入:任意支持远程 MCP 的客户端填
https://mcp.seodata.dev/mcp;也可以直接curlREST 接口,注册走POST /v1/register加邮箱验证码 5。 - 硬边界:它在页面上把自己写成「Free SEO data API」,当前交付的只有关键词这一层 8。SERP 结果、外链、关键词难度和趋势都还挂在「Coming soon」下面,按这一层的能力规划就好 5。页面写明数字来自 Google Ads 接口,看的是海外搜索需求 8。
想少拼几个零件:一个 Agent 串完五步
Easel:从热点发现到发布复盘,都在一个工作台里
ZJU-REAL/Easel 是浙江大学 REAL 实验室等团队开源的社媒内容工作台。底子是一个 OpenClaw Agent,外面接了账号画像、内容技能和真实的媒体工具 6。它按五层组织:发现适合账号的热点与机会,策划选题与排期,创作图文音视频,按平台适配后发布,最后读回表现并把有效经验写回账号画像 6。
这套流程里的技能配的是能跑的脚本,成品落进
outputs/ 目录并按项目归档,后续修改和重试不会散在聊天记录里 6。平台范围是它比较硬的一块。README 说目前支持小红书、抖音、快手、知乎、B 站、微信视频号和微信公众号七个平台的登录、适配与发布,并能回收账号数据 6。
仓库里列了 113 个技能 6。
- 典型使用场景:一个人运营两三个平台的账号,想让一个主题自动铺成小红书卡片、知乎长文和短视频三种形态;或者想把「哪类内容有效」这层经验沉淀下来,下一轮直接用。
- 安装与接入:Linux、macOS 或 Windows 10/11,Python 3.10 以上,跑
bash setup.sh走引导式安装。环境里还要有 Node.js 24.16+、26.1+ 或 27+、FFmpeg 和 Playwright 的 Chromium;FFmpeg 和 Chromium 缺失只会降级提示 6。装完用easel web打开本地工作台,模型 Key 在浏览器的设置页里填 6。 - 硬边界:Apache-2.0,最近提交 2026-10-11。README 有两条要读的提示:官方推荐用 Web 前端,纯 CLI 有一些终端显示问题;自动发布到小红书要谨慎,平台可能识别自动化操作 6。仓库的待办里还留着「适配 Windows」和「安装简易化」两项,Windows 下的浏览器发布全链路仍在完善 6。
这 6 个怎么排顺序
先装一个热榜入口,从最简单的开始。只想在自己的脚本里拿到榜单数据,用
DailyHotApi,一个地址就够。想要一个能翻的界面、还打算接 Agent,就部署
newsnow 并接上它的 MCP 服务,顺便给后面留好数据源。第二步装
TrendRadar,把热榜变成一条按点到达的简报。这一步要花的时间不在安装,在配置:关键词挑得准不准,直接决定推给你的东西还有没有用。第三步按你需要哪类数据二选一。要知道大家怎么评价这个话题,装
BettaFish,先拿一个自己熟悉的话题跑一遍,看它的报告结论和你的判断差多少。要知道有多少人在搜,接
seodata 的 MCP。它不需要安装,成本也最容易算。Easel 放到最后。它一条链路能省掉不少拼接,代价是安装链最长、要配的东西最多,而且它覆盖的发布环节会用到你的账号。先把前面几层跑顺,再决定要不要让它接管全流程。最后一条这 6 个共有:它们给的都是信号。哪个词值得写、这个话题该不该碰、这条内容该怎么发,判断仍然落在人这边。
Easel 在 README 里把小红书那一条标成需要人工确认,seodata 只给数字不给结论,两处都把最后一句话留给了人。References
- 1imsyy/DailyHotApi
github.com
- 2newsnext/newsnow
github.com
- 3sansan0/TrendRadar
github.com
- 4666ghj/BettaFish
github.com
- 5seodata.dev 给 Agent 的接口文档
seodata.dev
- 6ZJU-REAL/Easel
github.com
- 7TrendRadar 官方文档
trendradar.sandev.cc
- 8seodata.dev
seodata.dev
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.